CodeQL使用
1.基本使用
1.1 CodeQL 安装
CodeQL 的常用工具包括 CodeQL CLI、标准查询与库包,以及 Visual Studio Code 扩展。
CLI 用于创建数据库、执行查询和分析结果。GitHub 提供的 CodeQL Bundle 已包含 CLI 以及官方维护的标准查询和库包,通常优先下载 Bundle,不需要再单独克隆查询仓库。
标准查询和库包是开源的,既可以直接使用,也可以作为编写自定义查询的基础。
1.1.1 CLI 安装
首先在系统上选定CodeQL的安装位置。
从 CodeQL CLI Releases 下载适合当前系统的 CodeQL Bundle,解压到 ~/CodeQL 等固定目录。
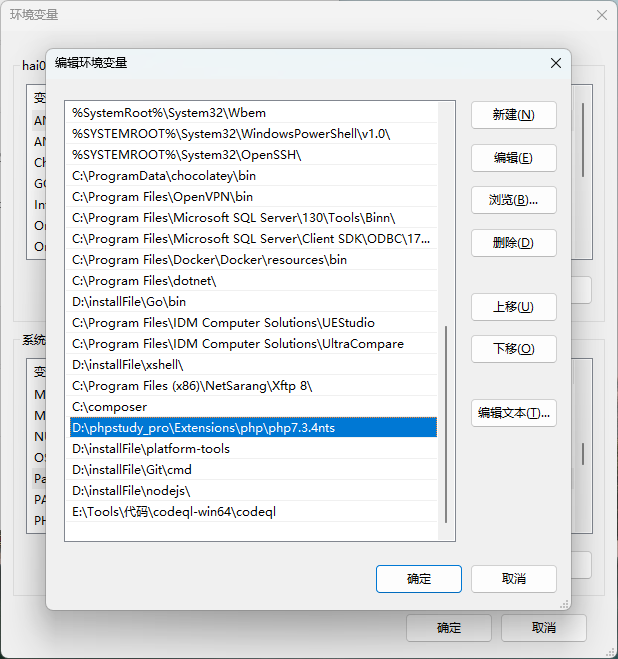
为方便调用,可将 codeql 可执行文件所在目录加入 PATH:
1.2 查询与库包
CodeQL Bundle 已包含官方标准查询和库包。只有在需要阅读最新源码、参与开发或使用仓库中特定版本时,才需要额外克隆 github/codeql;旧的 Semmle/ql 地址不再作为首选入口。
1.3.VSCode开发插件安装
CodeQL需要使用Visual Studio Code来开发和调试规则,所以我们需要在VSCode上面安装CodeQL的插件。
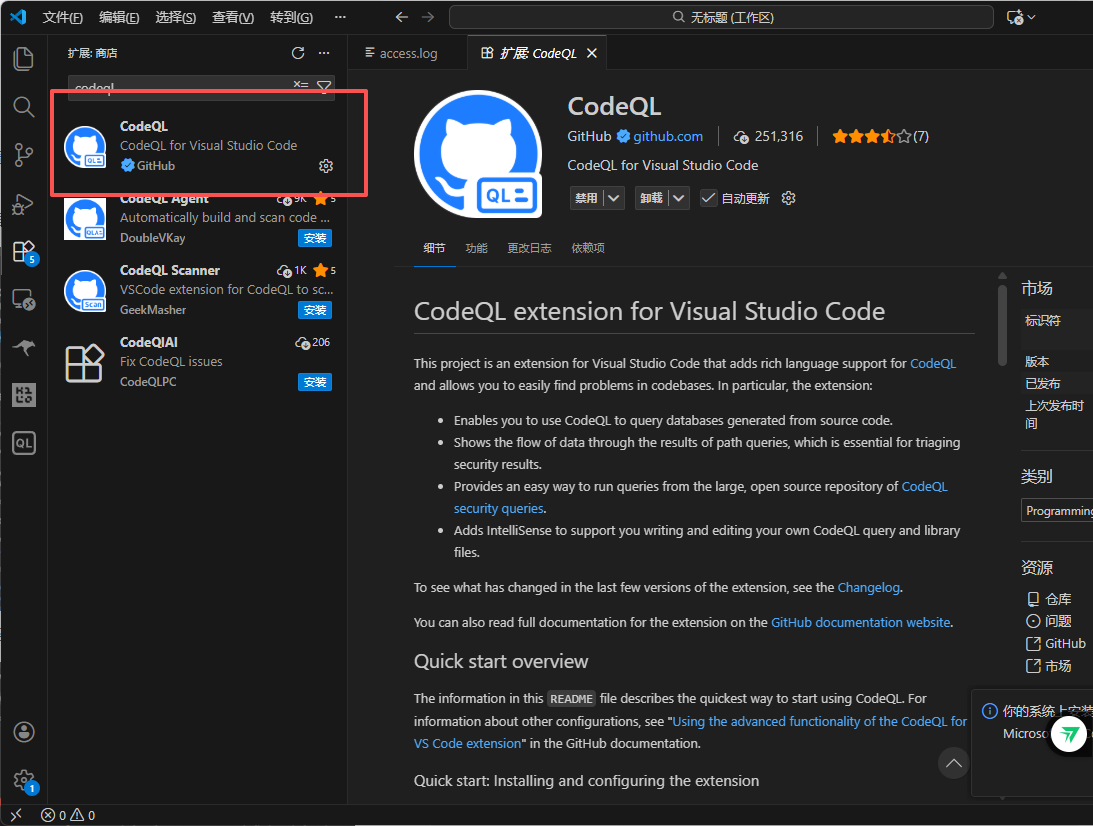
我们安装好Visual Studio Code后,在它的扩展里面搜索codeql, 点击安装。
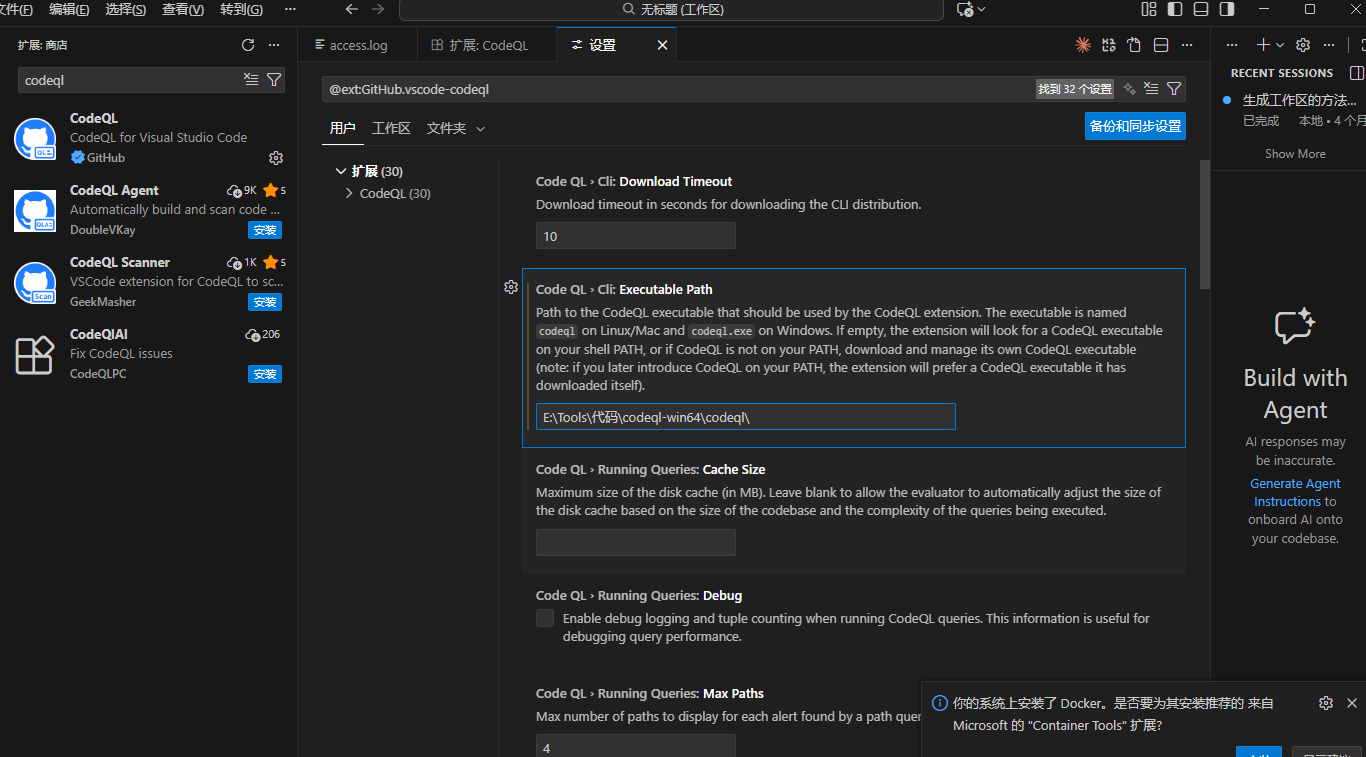
配置一下上面我们安装的codeql引擎路径,设置好了CodeQL的开发环境。
2.CodeQL简单使用
用的是这个靶场 —— micro_service_seclab:
生成数据库
CodeQL的核心引擎是不开源的,这个核心引擎的作用之一是帮助我们把micro-service-seclab转换成CodeQL能识别的中间层数据库。
codeql database create E:\Coding\CodeQL\CodeQL-Practice –language=”java” –source-root=E:\Coding\CodeQL\micro_service_seclab –command=”mvn clean package -Dmaven.test.skip=true”
codeql database create
/CodeQL/databases/codeql_demo 当然是指我们要创建的database为/CodeQL/databases/codeql_demo(注意:要先创建~/CodeQL/databases/目录)。--language=”java” 表示当前程序语言为Java。
--command=”mvn clean install –file pom.xml” 编译命令(因为Java是编译语言,所以需要使用–command命令先对项目进行编译,再进行转换,python和php这样的脚本语言不需要此命令)
--source-root=~/CodeQL/micro-service-seclab/ 这个当然指的是项目路径
然后我们需要编写QL查询语句来获取我们想要的数据
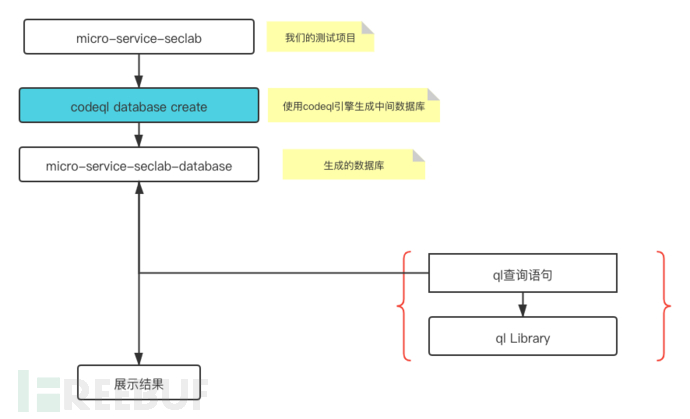
由于CodeQL开源了所有的规则和规则库部分,所以我们能够做的就是编写符合我们业务逻辑的QL规则
类似SQL语句:
1 | import java #导入Java的标准 CodeQL 库 |
基本语法包含3个部分。
| 名称类名 | 解释 | 代码中的对应形态 |
|---|---|---|
Method(方法类) |
定义/蓝图。它代表了程序员写在类里的那段“方法代码”本身。放在 from中表示遍历项目中所有声明的方法。 |
public void getUser(String name) { ... }(这就是一个 Method) |
MethodCall(方法调用类) |
动作/执行。它代表了代码在某个地方“执行”了上述方法的行为。放在 from中表示遍历项目中所有发生的方法调用动作。 |
db.getUser("admin");(这就是一个 MethodCall) |
Parameter(参数类) |
变量坑位。它代表了方法定义时,括号里写的那些用于接收数据的变量名(形参)。 | public void getUser(String name) 中的 String name |
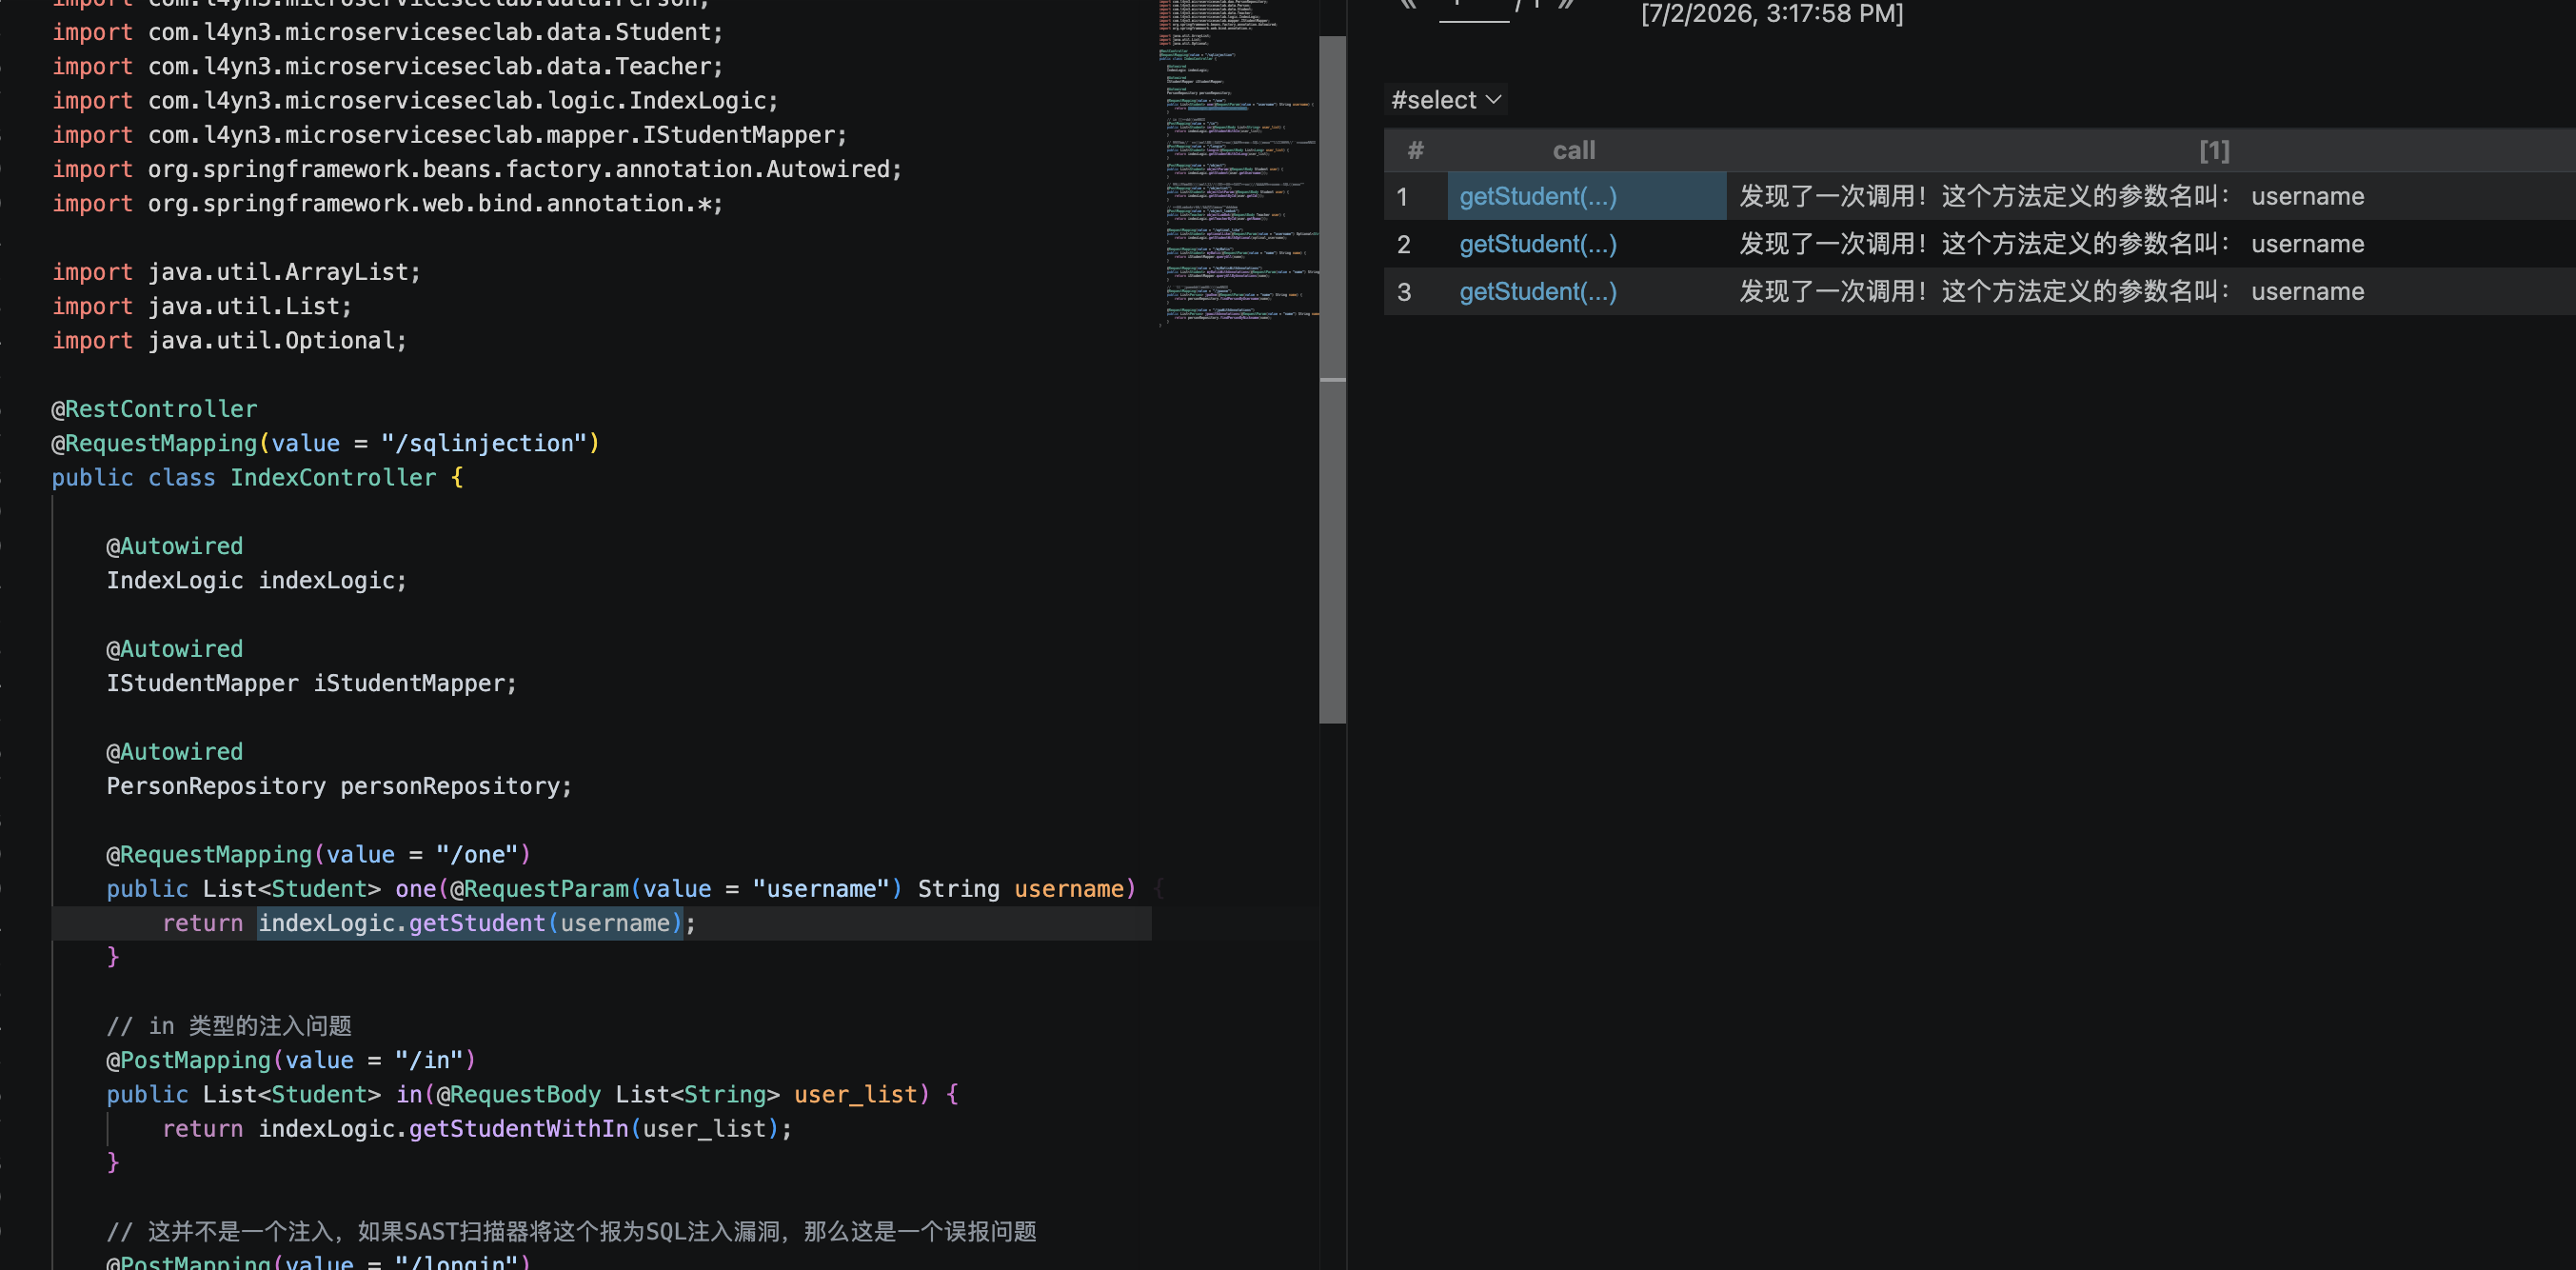
假设我们的目标是:“我想找到所有调用了 **getUser** 方法的地方,并且想知道这个方法定义的第一个参数叫什么名字。”
1 | import java |
3.CodeQL语法基本规则
3.1.谓词
官方文档:https://codeql.github.com/docs/ql-language-reference/predicates/
本质上就是 Java 里的方法(Method),或者是 SQL 里的过滤条件(WHERE)。
三种形态:
| 形态 | 像 Java 里的 | 例子 |
|---|---|---|
| 独立谓词(无归属) | 静态方法 | predicate isAdmin(string u) { u = "admin" } |
| 成员谓词(挂在类上) | 成员方法 | m.getName()、c.getArgument(0) |
| 特征谓词(类的构造函数) | 构造函数 | MyClass() { this.isPublic() } |
独立谓词
和SQL一样,where部分的查询条件如果过长,会显得很乱。CodeQL提供一种机制可以让你把很长的查询语句封装成函数。
分两种,有返回值和没有返回值
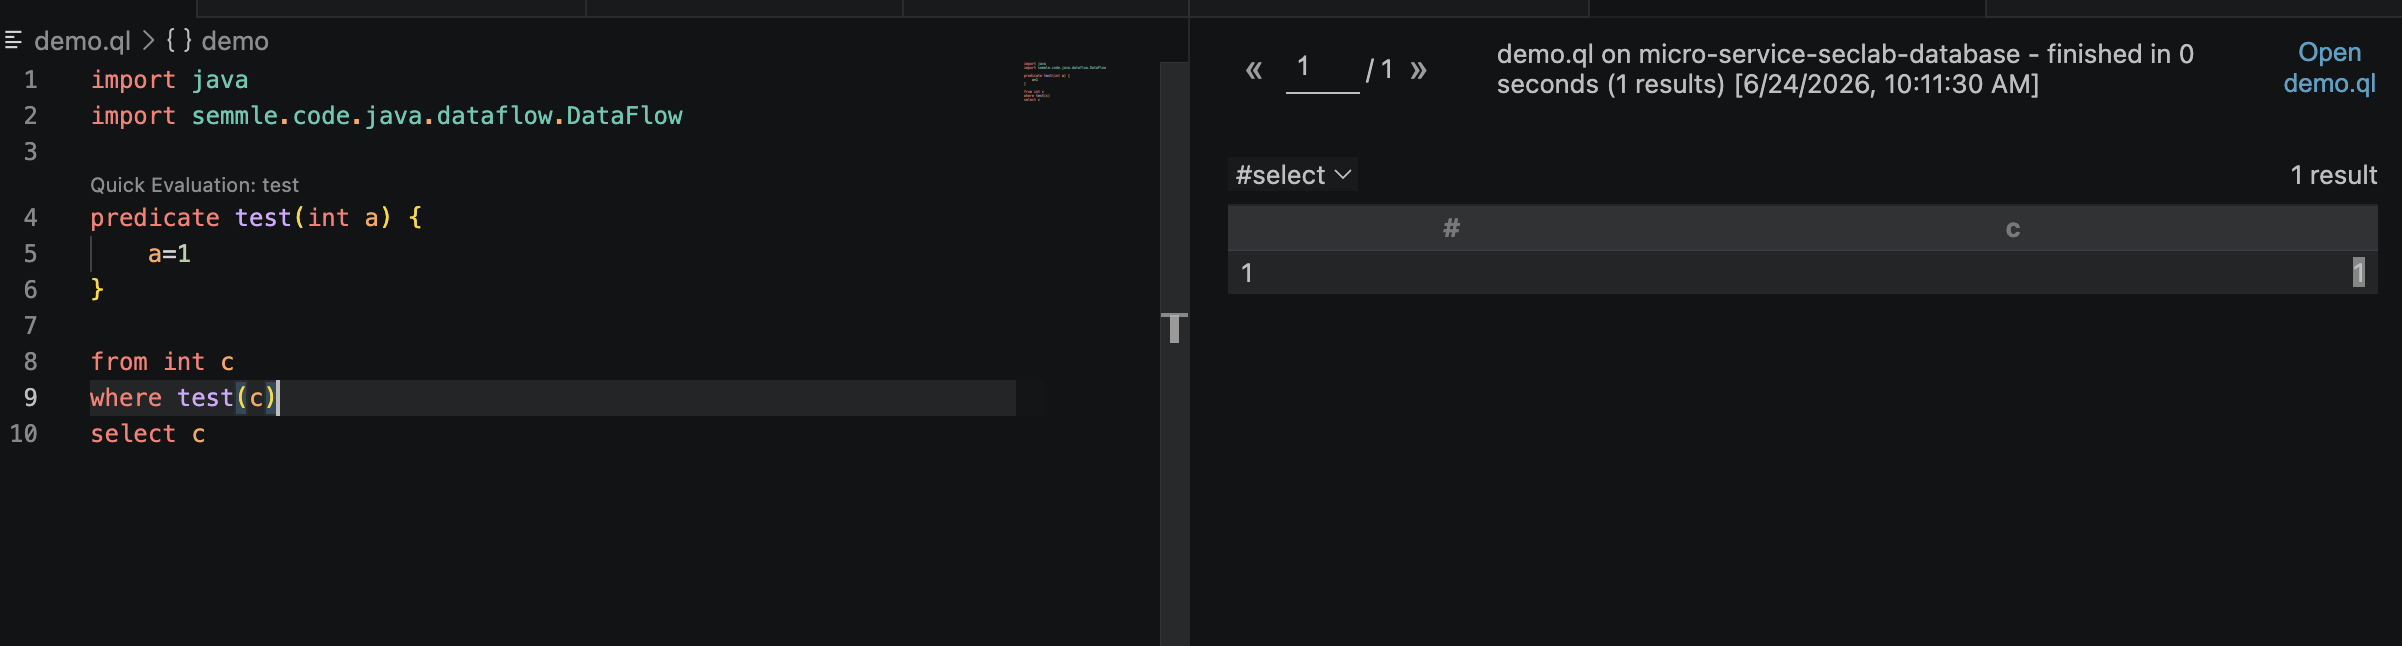
最基础的:**predicate**开头,不返回东西(只返回 true/false)
1 | import java |
带 result 的:把 **predicate**换成返回类型
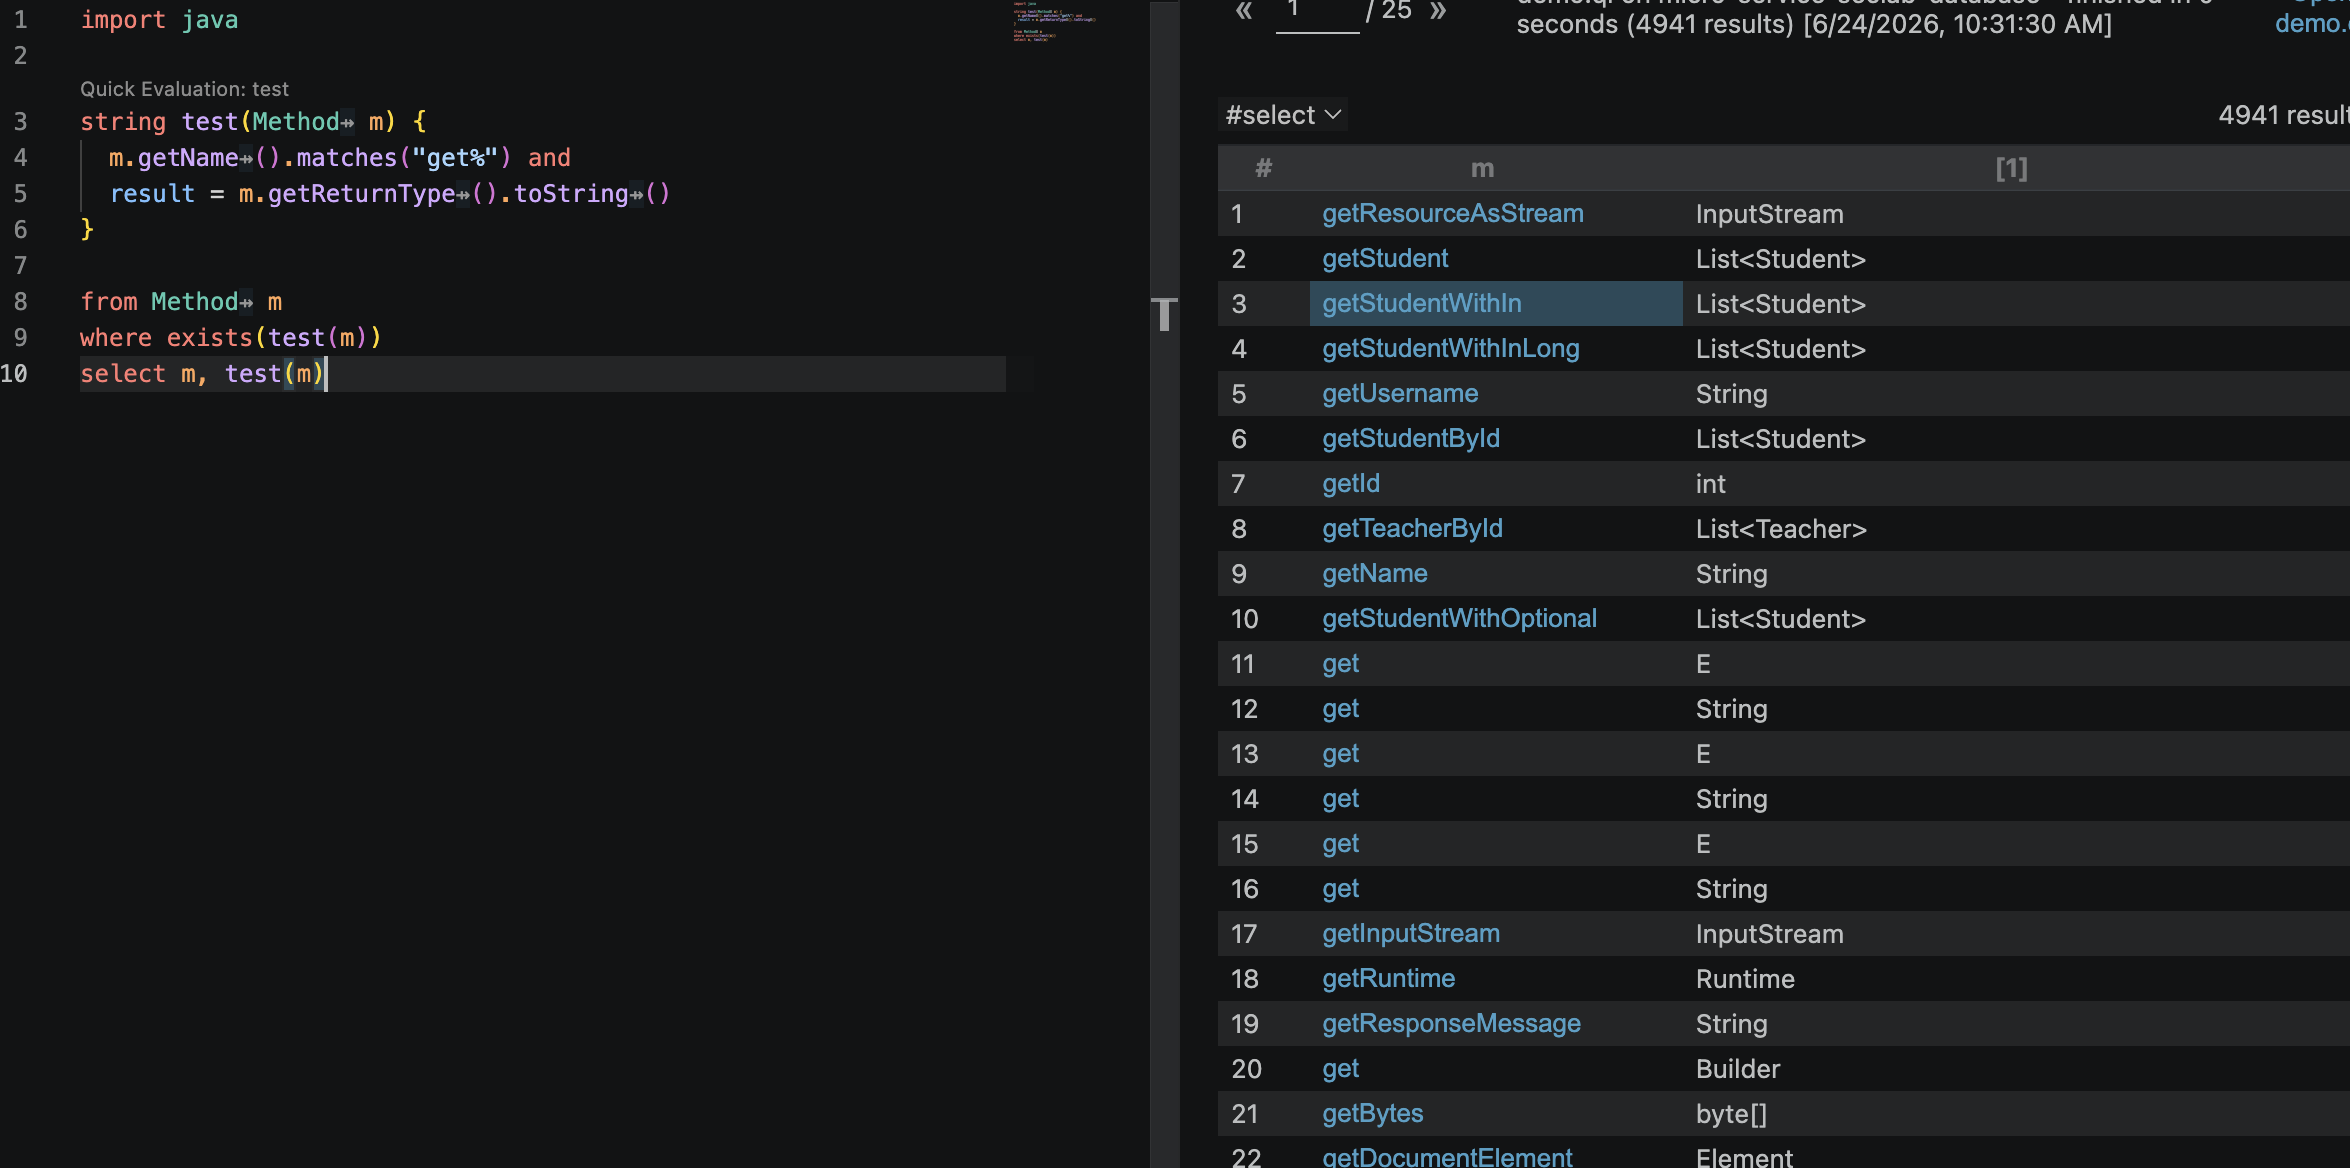
想找所有“返回类型是 String且名字以 get开头的方法”:
1 | import java |
成员谓词
常用的
| 谓词 | 用在什么类型上 | 作用 | 例子 |
|---|---|---|---|
.getName() |
Method、Class、Field、Parameter等 |
拿名字 | m.getName() = "executeQuery" |
.getDeclaringType() |
Method、Constructor、Field |
拿到声明这个东西的类 | c.getDeclaringType().hasQualifiedName("java.io", "FileReader") |
.getMethod() |
MethodCall |
拿到这个调用点调的是哪个方法 | call.getMethod().getName() = "query" |
.getArgument(i) |
Call |
拿到第 i 个实参(从0开始) | call.getArgument(0) |
.getAParameter() |
Method、Constructor |
拿到其中一个形参(可能多个) | `exists(Parameter p \ |
.getAnAnnotation() |
Annotatable(方法、类、字段等) |
拿到其中一个注解 | m.getAnAnnotation().getType().hasName("Override") |
.getType() |
各种表达式、变量 | 拿到类型 | p.getType().hasName("String") |
.hasName(s) |
Method、Class、Type等 |
名字是否等于 s | type.hasName("String") |
.hasQualifiedName(pkg, cls) |
RefType |
全限定名是否匹配 | type.hasQualifiedName("java.io", "File") |
处理集合和条件时常用
| 谓词/关键字 | 作用 | 例子 |
|---|---|---|
exists(...) |
“有没有至少一个?” | `exists(Parameter p \ |
forall(...) |
“是不是全都满足?” | `forall(Parameter p \ |
none(...) |
“是不是一个都没有?” | `none(Parameter p \ |
instanceof |
检查类型 | src instanceof StringLiteral |
matches(pattern) |
字符串模糊匹配(% 是通配符) | s.matches("%admin%") |
regexpMatch(pattern) |
正则匹配 | s.regexpMatch(".*\\$\\{.*") |
数据流分析专用
| 谓词 | 作用 | 用在什么地方 |
|---|---|---|
DataFlow::exprNode(e) |
把表达式转成数据流节点 | 把 Expr塞进 localFlow |
DataFlow::parameterNode(p) |
把参数转成数据流节点 | 同上 |
DataFlow::localFlow(src, sink) |
同一方法内,值能从 src 流到 sink 吗 | 局部数据流分析 |
isSource(node) |
定义“污点从哪里来” | 写在 TaintTracking::Configuration里 |
isSink(node) |
定义“污点流到哪里算危险” | 同上 |
hasFlow(src, sink) |
全局范围内,有没有一条污点路径 | 执行全局污点追踪 |
hasFlowPath(src, sink) |
同上,但能输出路径(画线) | 路径查询 |
3.2.类
这里的 Method就是一个类,它代表数据库中所有方法定义的集合。m是集合里的一个具体元素(一个方法)。
当自己定义类时,通常是为了:
- 给某个类型加一个更精细的筛选条件。
- 把多个相关类型统一成一个抽象类(比如
SqlExpr)。 - 给已有的类添加新的成员谓词(通过继承)。
**Method**、**IfStmt**、**Parameter**这些都是类。比如:
1 | from Method m |
这里的 Method就是一个类,它代表数据库中所有方法定义的集合。m是集合里的一个具体元素(一个方法)。
官方文档说:“类是一组值的集合。” 对,Method就是所有方法值的集合。
类是怎么定义的
1 | class OneTwoThree extends int { |
类的成员谓词
类里面可以定义成员谓词,就像 Java 类里的方法。官方例子:
1 | class OneTwoThree extends int { |
抽象类
官方例子:你想描述“所有可能被解释为 SQL 查询的表达式”。不同数据库(PostgreSQL、MySQL)的 SQL 表达式不同,但你可以定义一个抽象类 SqlExpr:
1 | abstract class SqlExpr extends Expr { |
然后为每种数据库定义子类:
1 | class PostgresSqlExpr extends SqlExpr { ... } |
抽象类的好处:你可以在 SqlExpr上定义通用的成员谓词,然后所有子类都能用。如果需要支持新数据库,只需加一个子类,不用改已有查询。
类比:
“动物”是一个抽象类,它包含“狗”、“猫”、“鸟”等子类。你可以定义“动物都会叫”,然后狗叫汪汪,猫叫喵喵。
继承和覆盖
子类可以覆盖(override)父类的成员谓词。官方例子:
1 | class OneTwo extends OneTwoThree { |
OneTwo继承了OneTwoThree,但覆盖了getAString()。- 对于值 1 和 2,调用
getAString()时会使用OneTwo的版本(“One or two: …”),而不是OneTwoThree的版本。 - 对于值 3,它不属于
OneTwo,所以仍用OneTwoThree的版本。
关键点:CodeQL 会根据值所属的最具体类来决定调用哪个版本的谓词。这叫“多态”。
类和数据库类型的关系
用的 Method、IfStmt这些类,实际上是 CodeQL 库预先定义好的,它们对应数据库里的表。比如 Method对应数据库里的 @method表。你不需要自己定义它们,直接拿来用就行。
当你自己定义类时,通常是为了:
- 给某个类型加一个更精细的筛选条件(比如
OneTwoThree只包含 1、2、3)。 - 把多个相关类型统一成一个抽象类(比如
SqlExpr)。 - 给已有的类添加新的成员谓词(通过继承)。
和Java中的类来举例子
区别一、Java 类是用来“创建对象”的,CodeQL 类是用来“筛选值”的
1 | class PublicMethod extends Method { |
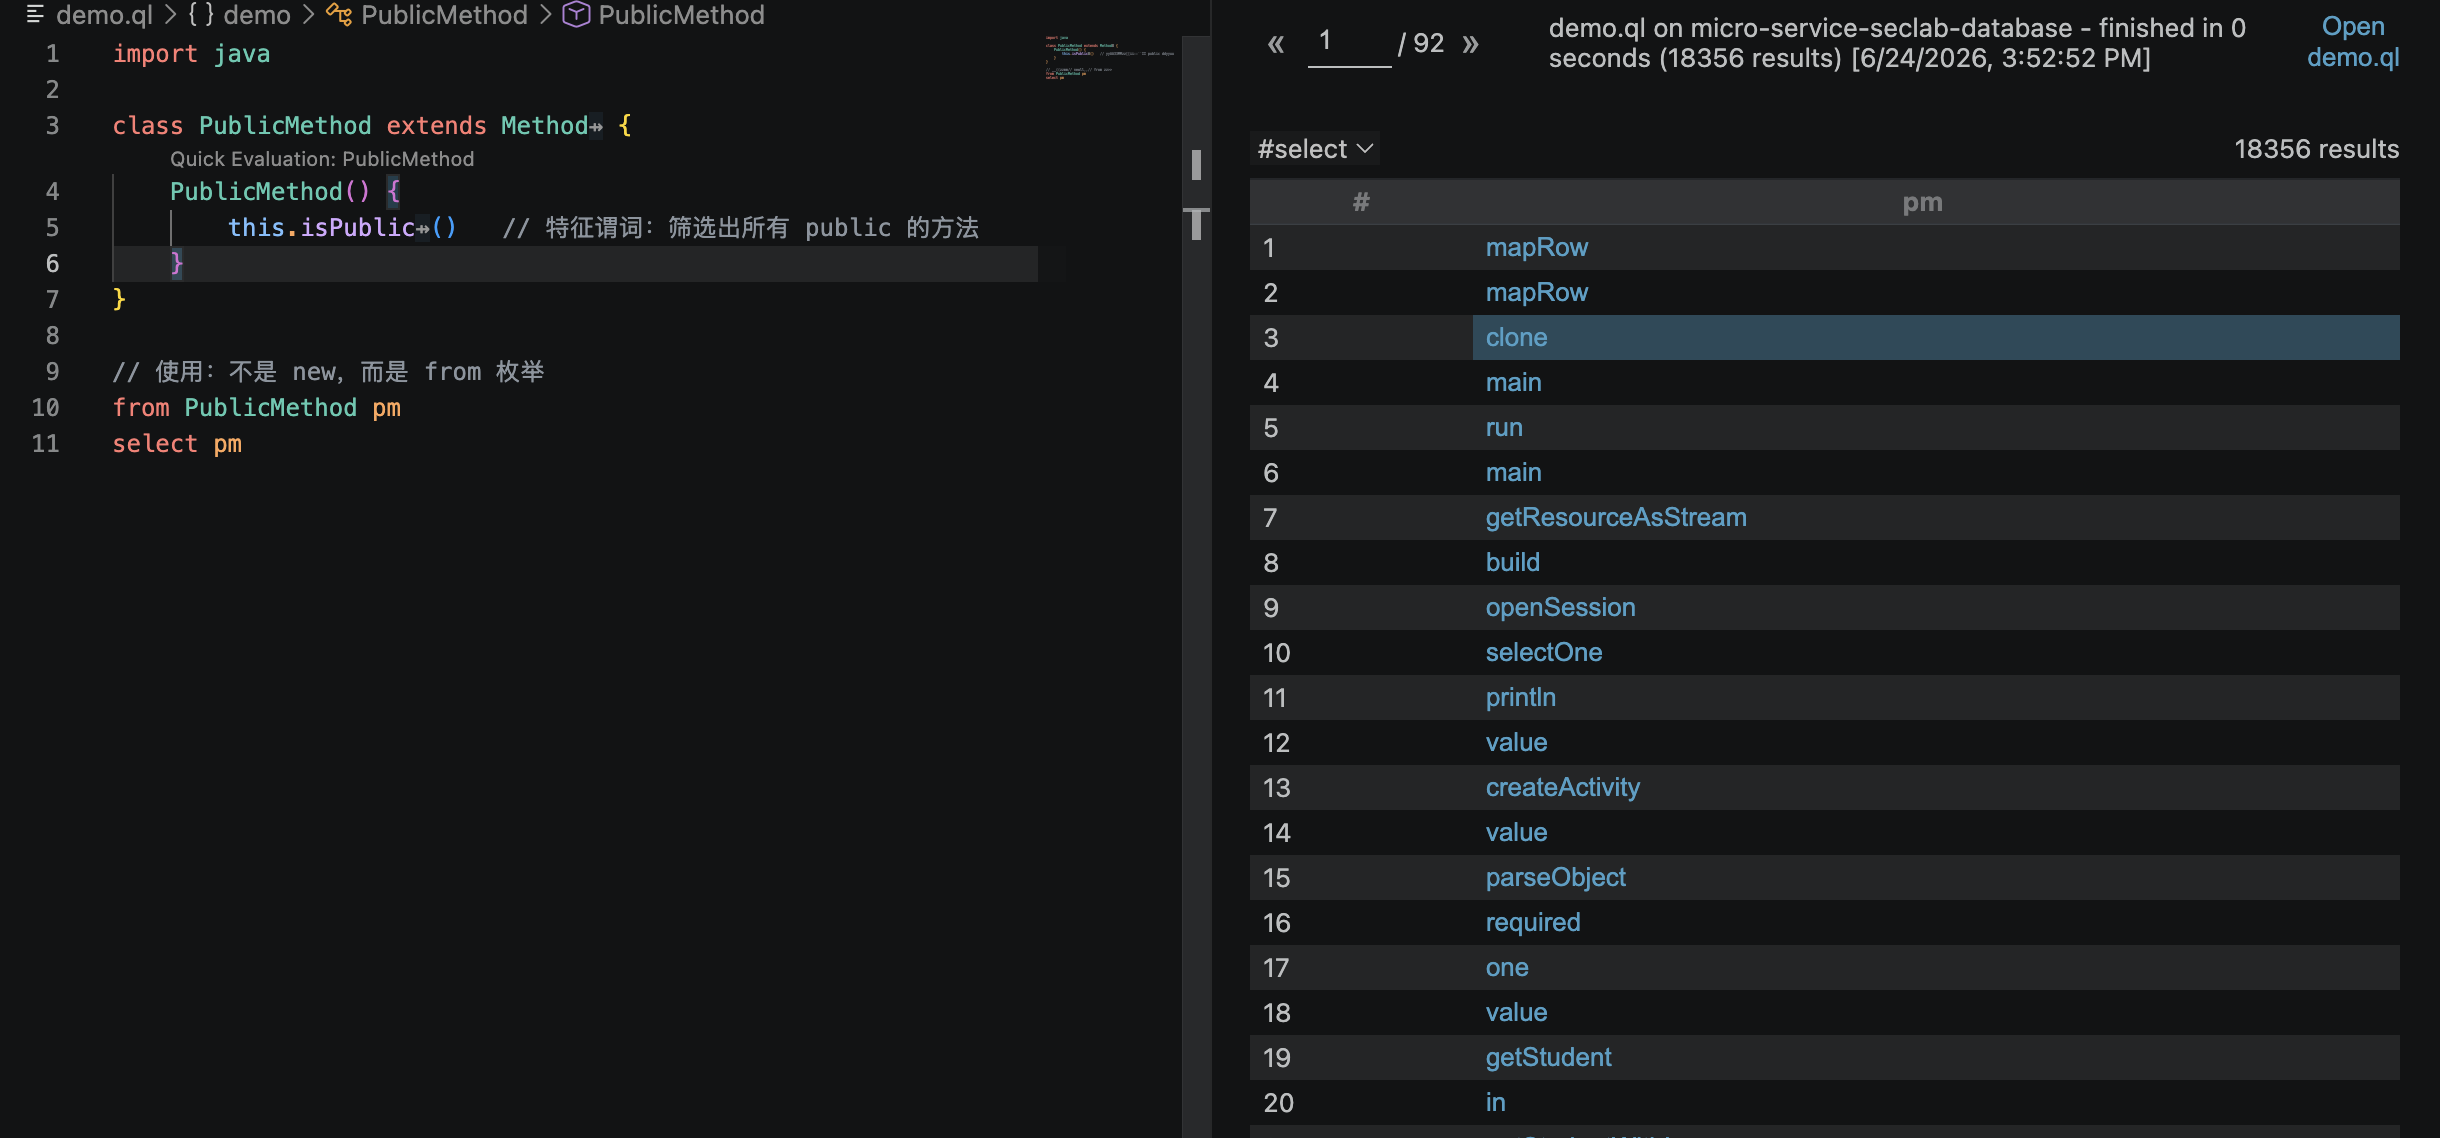
关键区别:
- Java:
new xxxx(...)创建了一个新的对象。 - CodeQL:
PublicMethod类不是创建新方法,而是从已有的所有方法中挑出那些 public 的。
区别二、特征谓词是 CodeQL 独有
CodeQL 的特征谓词是定义准入条件的:
1 | PublicMethod() { |
特征谓词不是“创建”,而是“判断”。它不产生新东西,只是决定哪些已有的值能进这个类。Java是直接new一个对象出来。
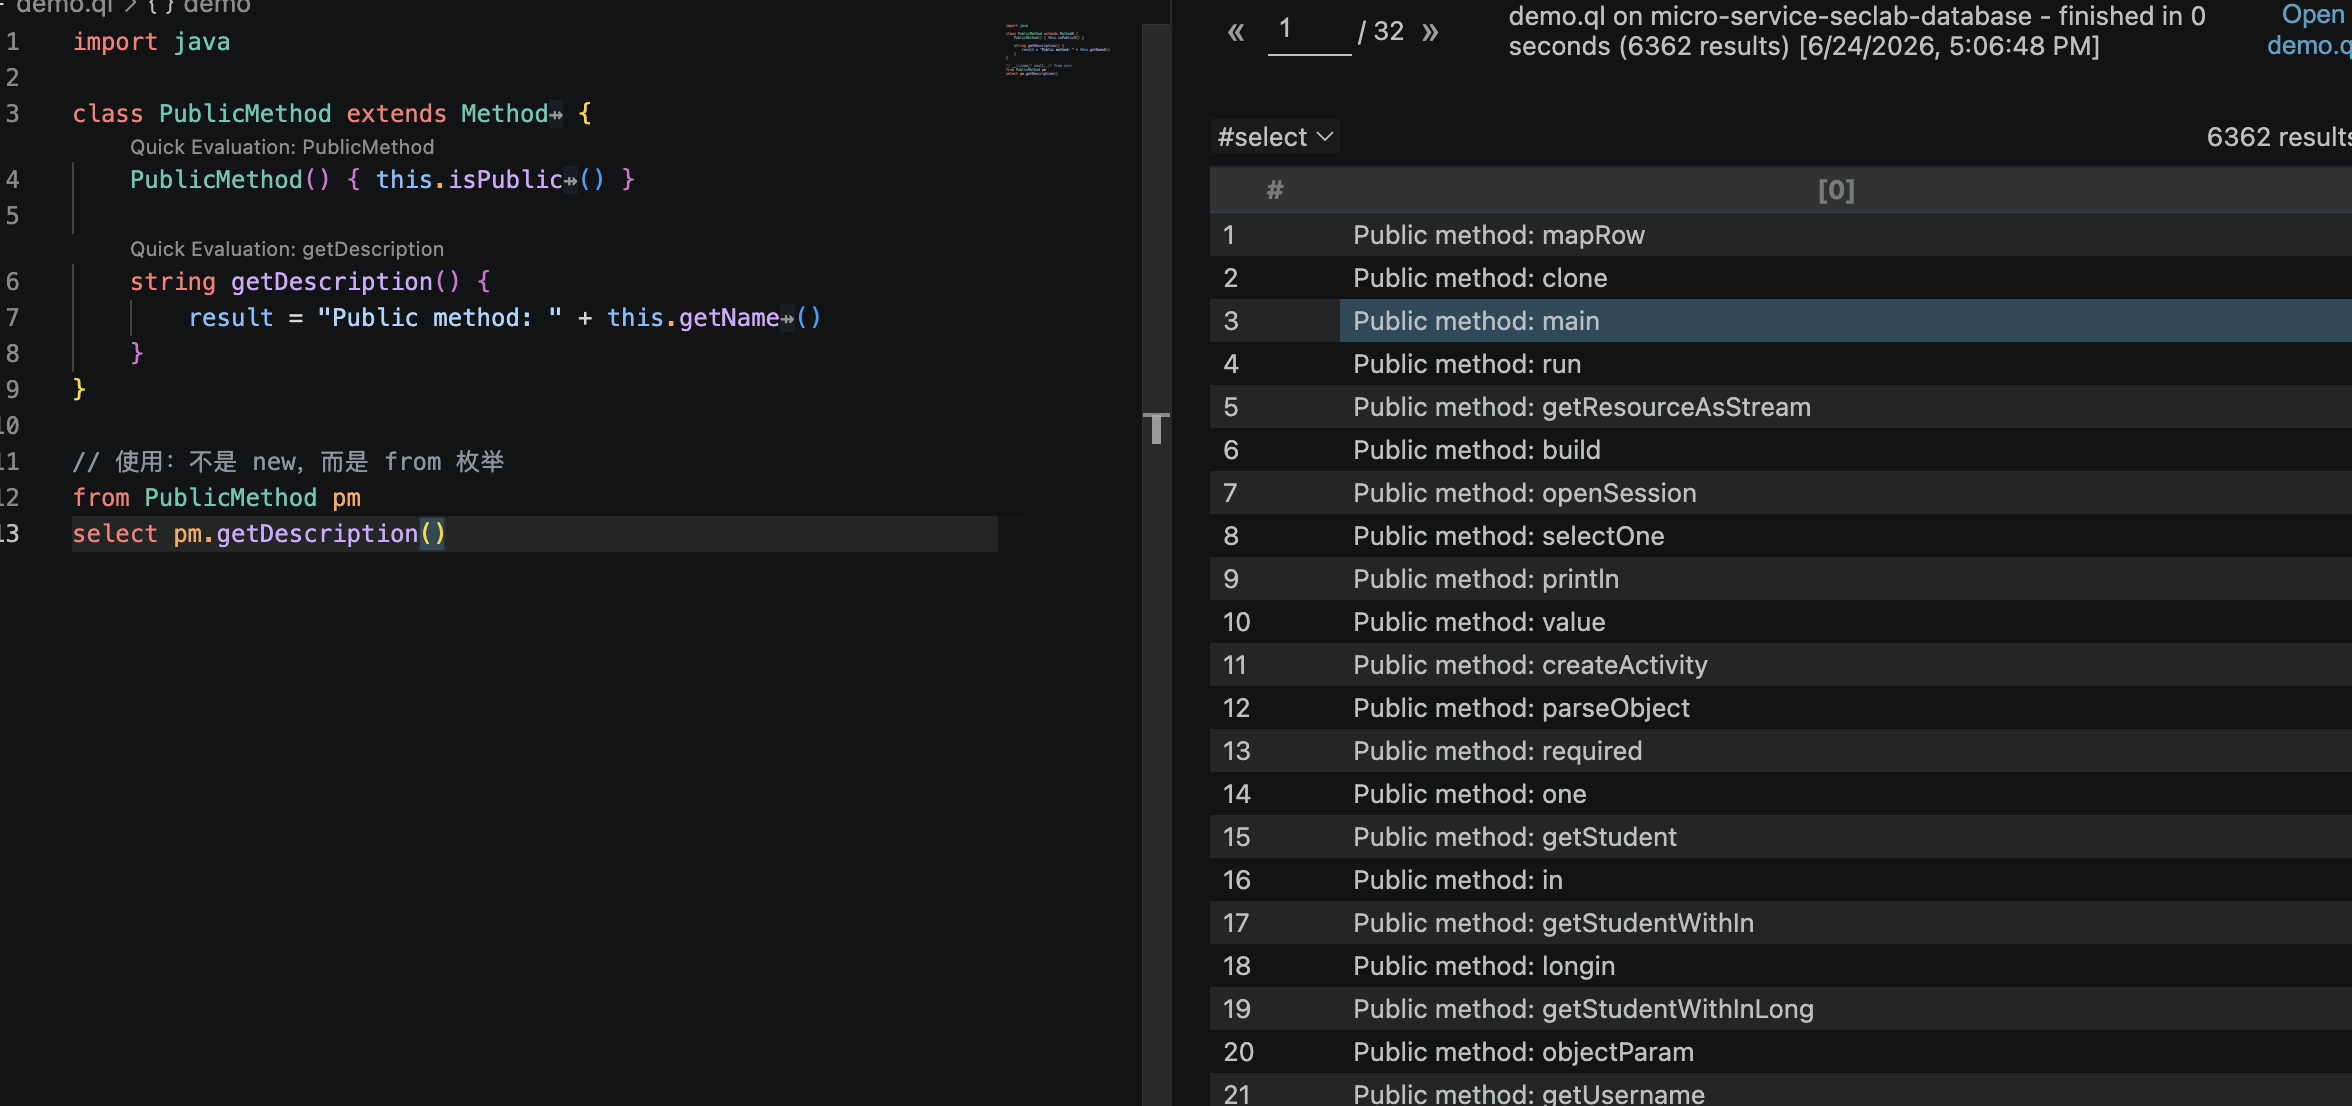
区别三:CodeQL 的类不封装数据,只封装查询逻辑
CodeQL 的类不能存数据,只能定义查询逻辑(成员谓词):
1 | class PublicMethod extends Method { |
getDescription()不是从字段里读数据,而是从已有的 Method 节点上计算出来的。
3.3.量词
在查询里临时引入一些变量,用来检查“有没有”或“是不是全都”满足某个条件。
exists(变量声明 | 条件)
forall(变量声明 | 范围条件 | 检查条件)
forex(变量声明 | 范围条件 | 检查条件)
- 变量声明:临时变量,比如
int i、Parameter p。- 范围条件(仅 forall/forex):限定变量的取值范围,比如
p = m.getAParameter()。- 检查条件:对范围内的每个变量进行检查,比如
p.getType().hasName("String")。
1.exists
exists(变量声明 | 条件)
最常用,用来检查是否存在至少一个满足条件的值。
这个方法有没有一个形参是 String 类型
1 | exists(Parameter p | p = m.getAParameter() and p.getType().hasName("String")) |
2.forall
forall(变量声明 | 范围条件 | 检查条件)
用来检查是否存在全部满足条件的值。
这个方法的所有形参,是不是全都是 String 类型
注意:如果这个方法没有形参,forall会认为“全都满足” → true。这叫做“空真”。
1 | forall(Parameter p | p = m.getAParameter() | p.getType().hasName("String")) |
3.forex
forex(变量声明 | 范围条件 | 检查条件)
检查“至少有一个,且全都”
forex就是 forall+ exists的组合,避免了空真问题。
这个方法至少有一个形参,并且所有形参都是 String 类型。
1 | forex(Parameter p | p = m.getAParameter() | p.getType().hasName("String")) |
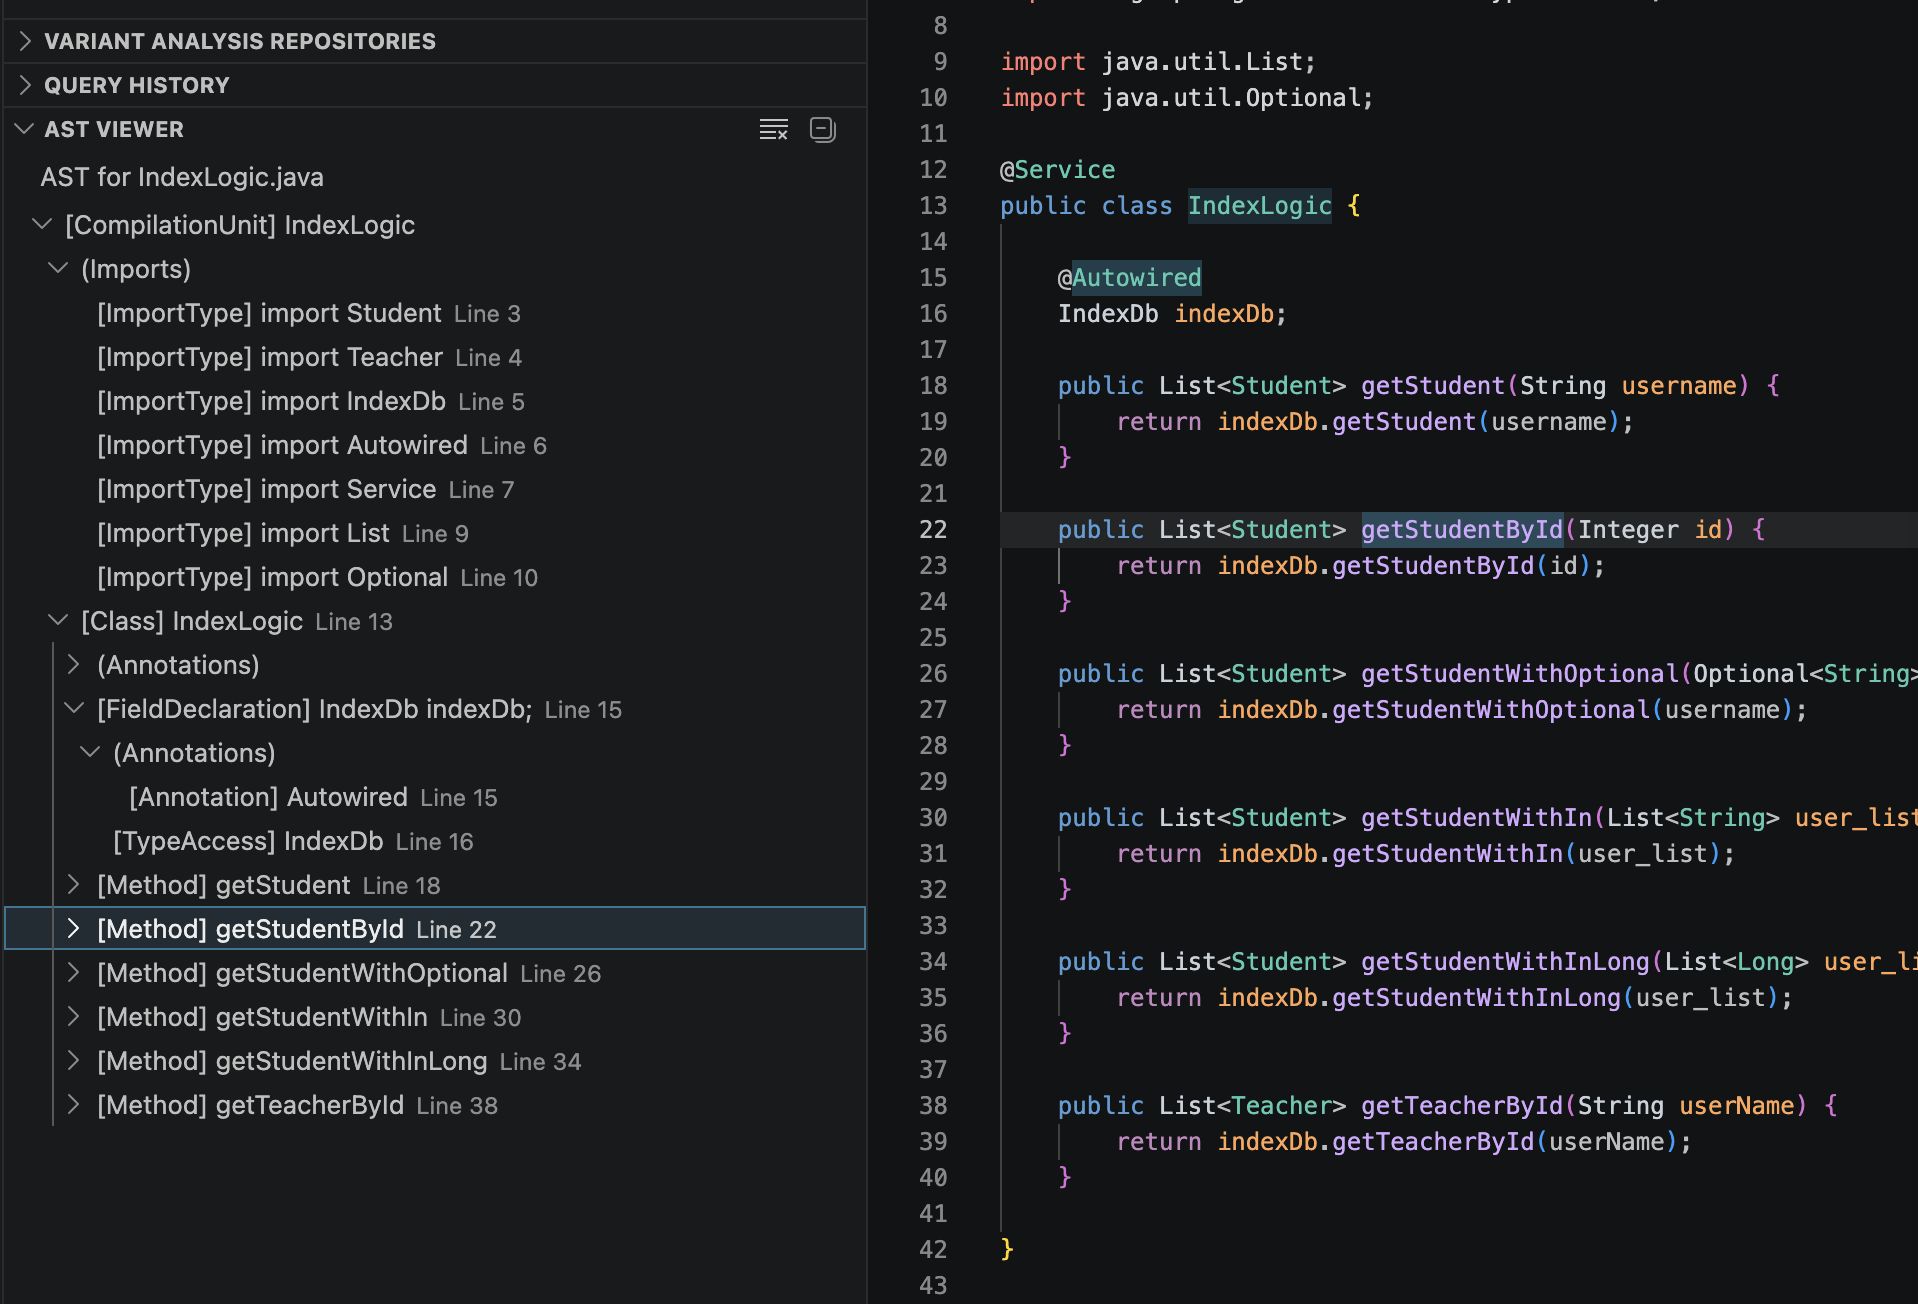
3.4.AST 与 注解
Java AST语法树
官方的说法:AST 代表程序的语法结构,节点代表语句和表达式。
AST 节点 = 代码零件的名字,写查询就是按名字找零件
语句(Stmt) 是动作(if、while、return),表达式(Expr) 是值(加法、变量、调用)。
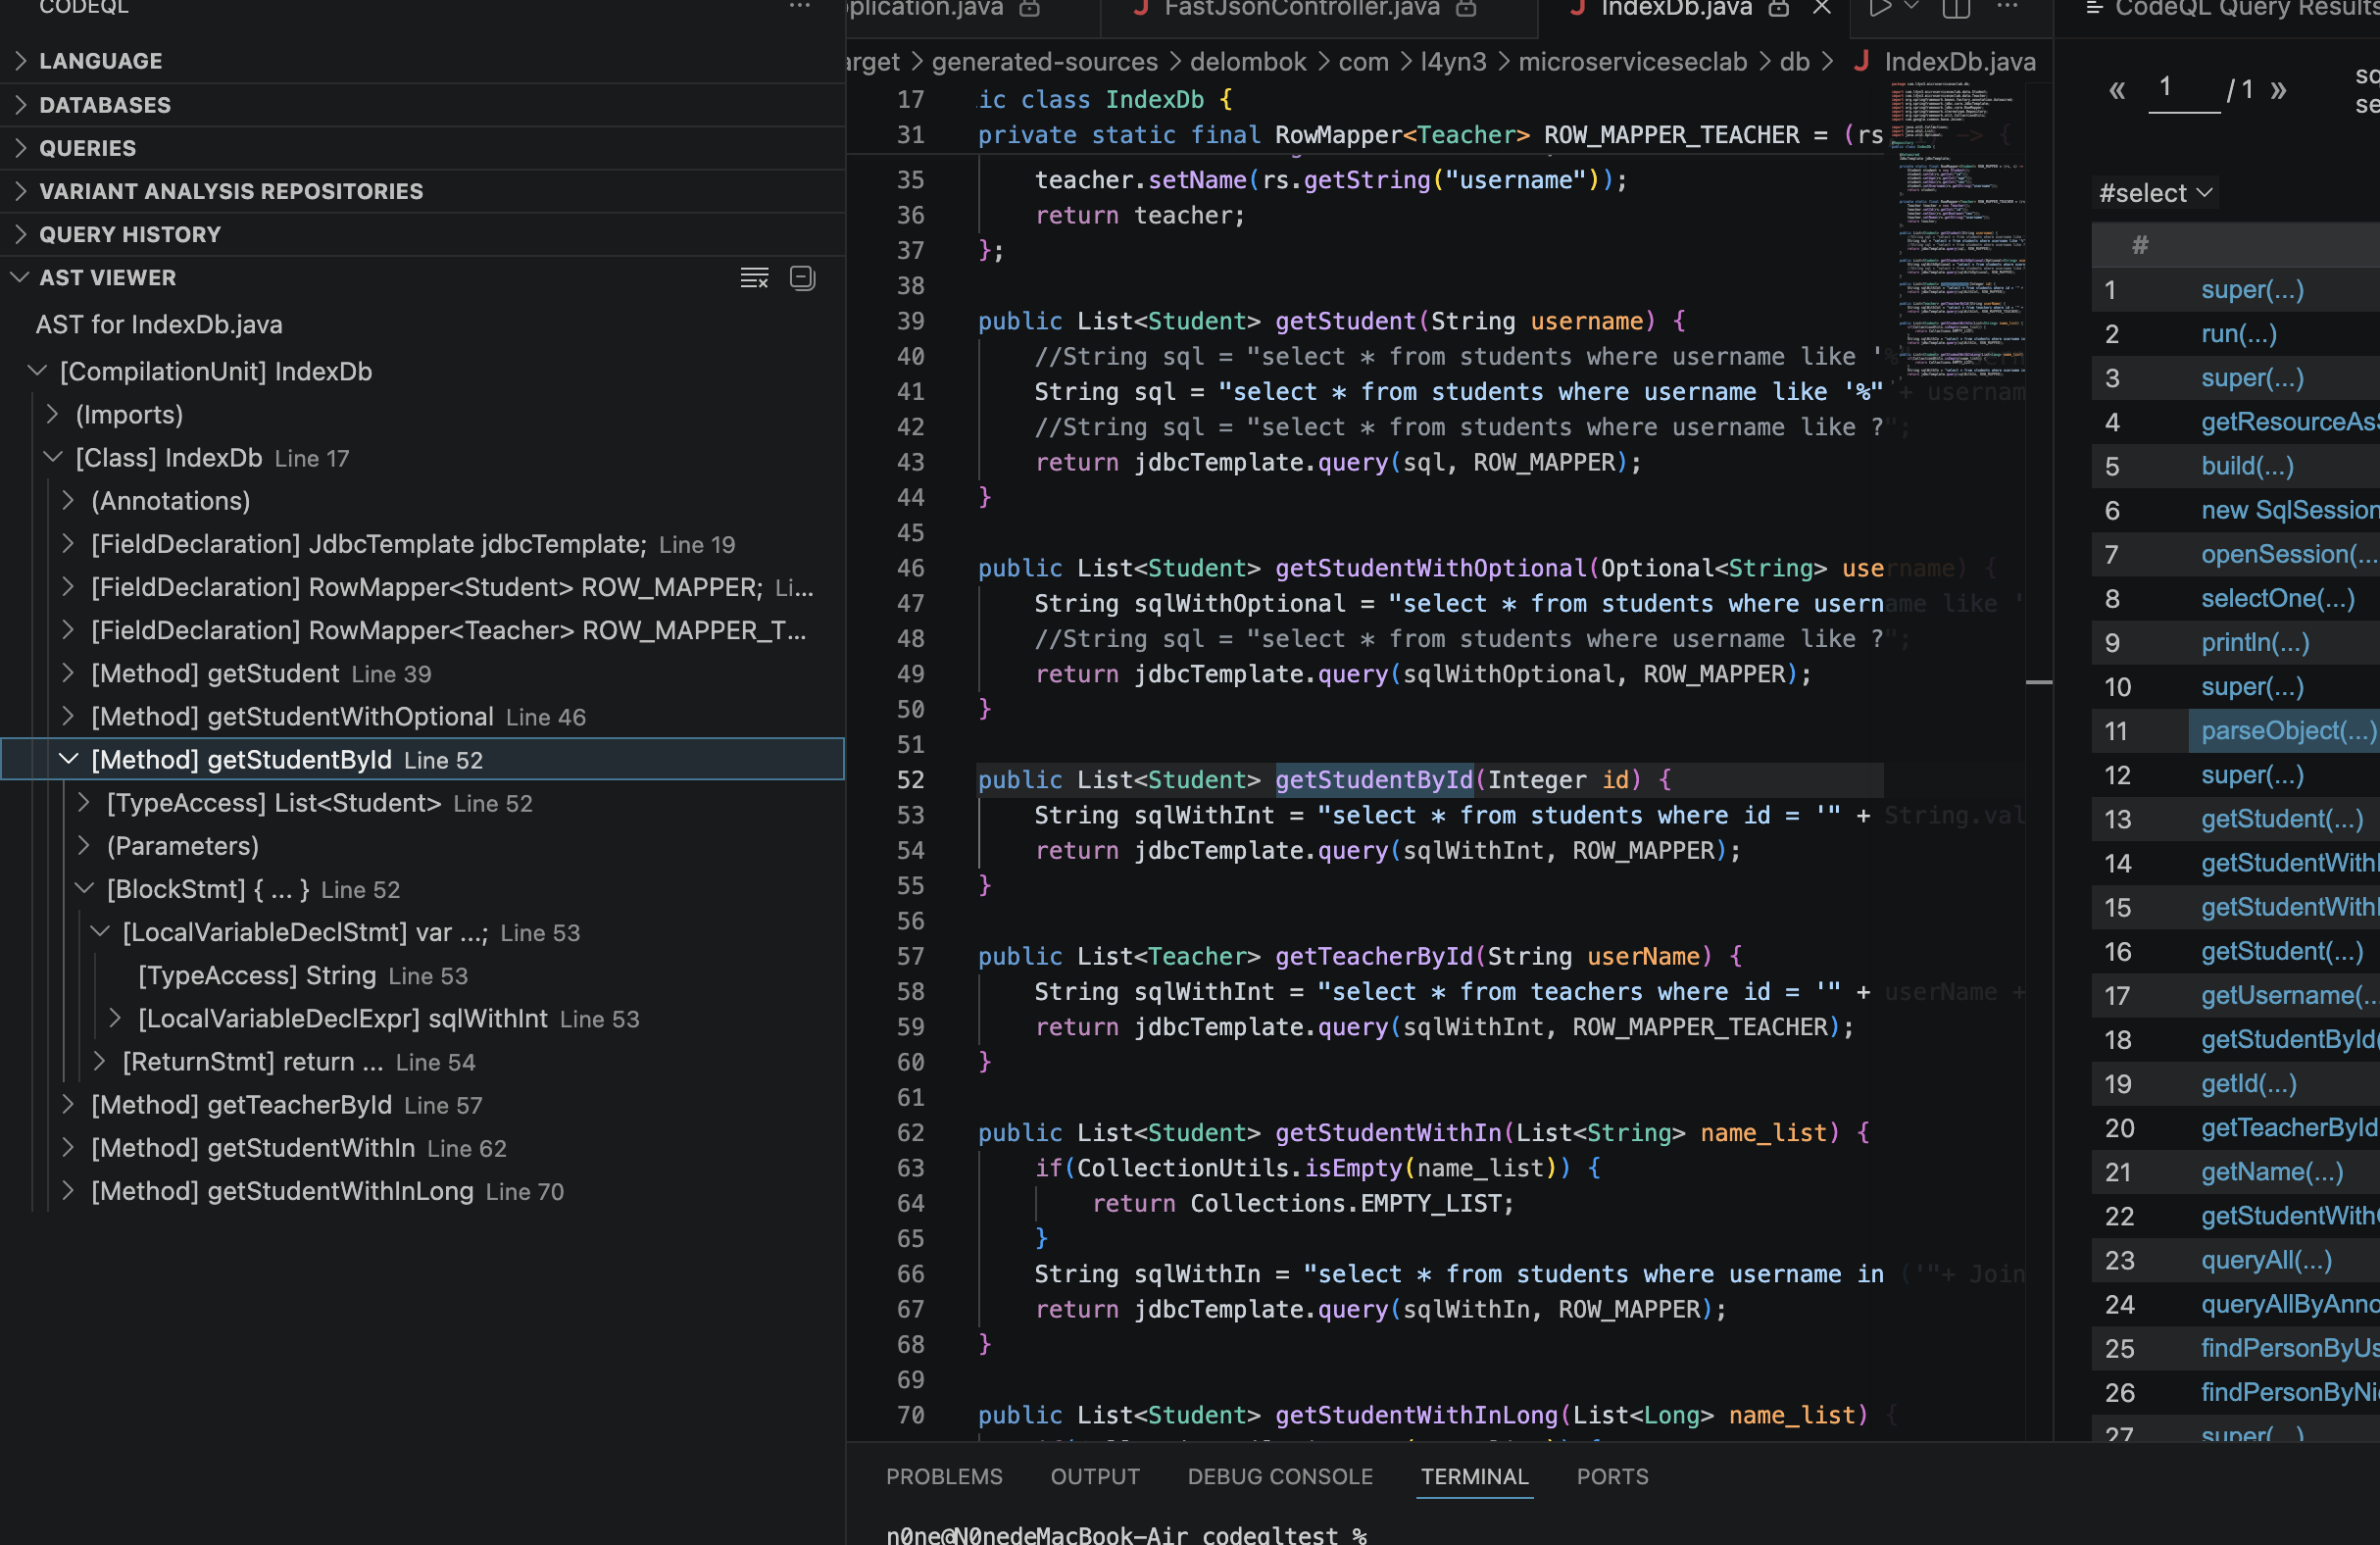
遇到不认识的节点,就打开 AST 视图看一眼,比看文档快十倍
自己查看AST语法树操作步骤:
- 打开一个 Java 文件。
- 右键 →
CodeQL: View AST。- 在 AST 树里,随便点一个节点,看它的类名。
- 对照上面的表格,你就知道这个节点叫什么了。
语句(Stmt)和表达式(Expr)
| 阵营 | 代表什么 | 例子 | 特点 |
|---|---|---|---|
| Stmt(语句) | 一句完整的“命令”,以分号或花括号结尾 | if、while、return、{ } |
不产生值,只执行动作 |
| Expr(表达式) | 一个“值”,可以计算、赋值、传参 | 1 + 2、"hello"、obj.foo() |
产生一个值,可以嵌套在语句里 |
语句类(Stmt)
官方表格里列了一大堆,但你只需要记住最常用的 8 个(其他的遇到再查):
| 你写的 Java 代码 | CodeQL 类名 | 你什么时候用 |
|---|---|---|
if (cond) ... |
IfStmt |
找所有 if |
while (cond) ... |
WhileStmt |
找所有 while |
for (...;...;...) ... |
ForStmt |
找普通 for |
for (Type x : list) ... |
EnhancedForStmt |
找 foreach |
return expr; |
ReturnStmt |
找 return |
throw expr; |
ThrowStmt |
找 throw |
try { ... } catch ... |
TryStmt |
找 try |
{ ... } |
BlockStmt |
找代码块 |
表达式类(Expr)
字面量(Literal)—— 直接写死的值
| 代码 | CodeQL 类 | 例子 |
|---|---|---|
true/ false |
BooleanLiteral |
from BooleanLiteral b |
23 |
IntegerLiteral |
整数常量 |
"hello" |
StringLiteral |
字符串常量 |
null |
NullLiteral |
null |
一元运算(UnaryExpr)—— 单个操作数
| 代码 | CodeQL 类 | 例子 |
|---|---|---|
x++ |
PostIncExpr |
后置自增 |
++x |
PreIncExpr |
前置自增 |
!flag |
LogNotExpr |
逻辑非 |
-num |
MinusExpr |
负号 |
二元运算(BinaryExpr)—— 两个操作数
| 代码 | CodeQL 类 | 例子 |
|---|---|---|
a + b |
AddExpr |
加法 |
a - b |
SubExpr |
减法 |
a == b |
EQExpr |
相等判断 |
a && b |
AndLogicalExpr |
逻辑与 |
赋值运算(AssignExpr 等)
| 代码 | CodeQL 类 |
|---|---|
x = 1 |
AssignExpr |
x += 1 |
AssignAddExpr |
x *= 2 |
AssignMulExpr |
访问和调用(Access)
| 代码 | CodeQL 类 | 说明 |
|---|---|---|
this |
ThisAccess |
当前对象 |
x |
VarAccess |
变量访问 |
obj.field |
FieldAccess |
字段访问 |
arr[i] |
ArrayAccess |
数组下标 |
foo() |
MethodCall |
方法调用 |
new Foo() |
ClassInstanceExpr |
创建对象 |
其他常用
| 代码 | CodeQL 类 | 说明 |
|---|---|---|
(int)x |
CastExpr |
类型转换 |
x instanceof String |
InstanceOfExpr |
类型检查 |
cond ? a : b |
ConditionalExpr |
三目运算符 |
String.class |
TypeLiteral |
类字面量 |
@Override |
Annotation |
注解 |
注解
注解在 CodeQL 里的四个零件
| 零件 | 官方类名 | 解释 | 例子 |
|---|---|---|---|
| 能被贴标签的东西 | Annotatable |
任何可以写 @XXX的地方:类、方法、字段、参数、局部变量、包 |
class Foo、void bar()、String name |
| 标签的种类 | AnnotationType |
注解的“定义”,比如 @Override这个标签本身是什么 |
java.lang.Override、java.lang.Deprecated |
| 标签里的填空项 | AnnotationElement |
注解里的小括号参数,比如 @SuppressWarnings("rawtypes")里的 "rawtypes" |
value、name |
| 贴上去的那张纸 | Annotation |
代码里实际写出来的 @XXX(...)这个具体实例 |
@Override、@SuppressWarnings("deprecation") |
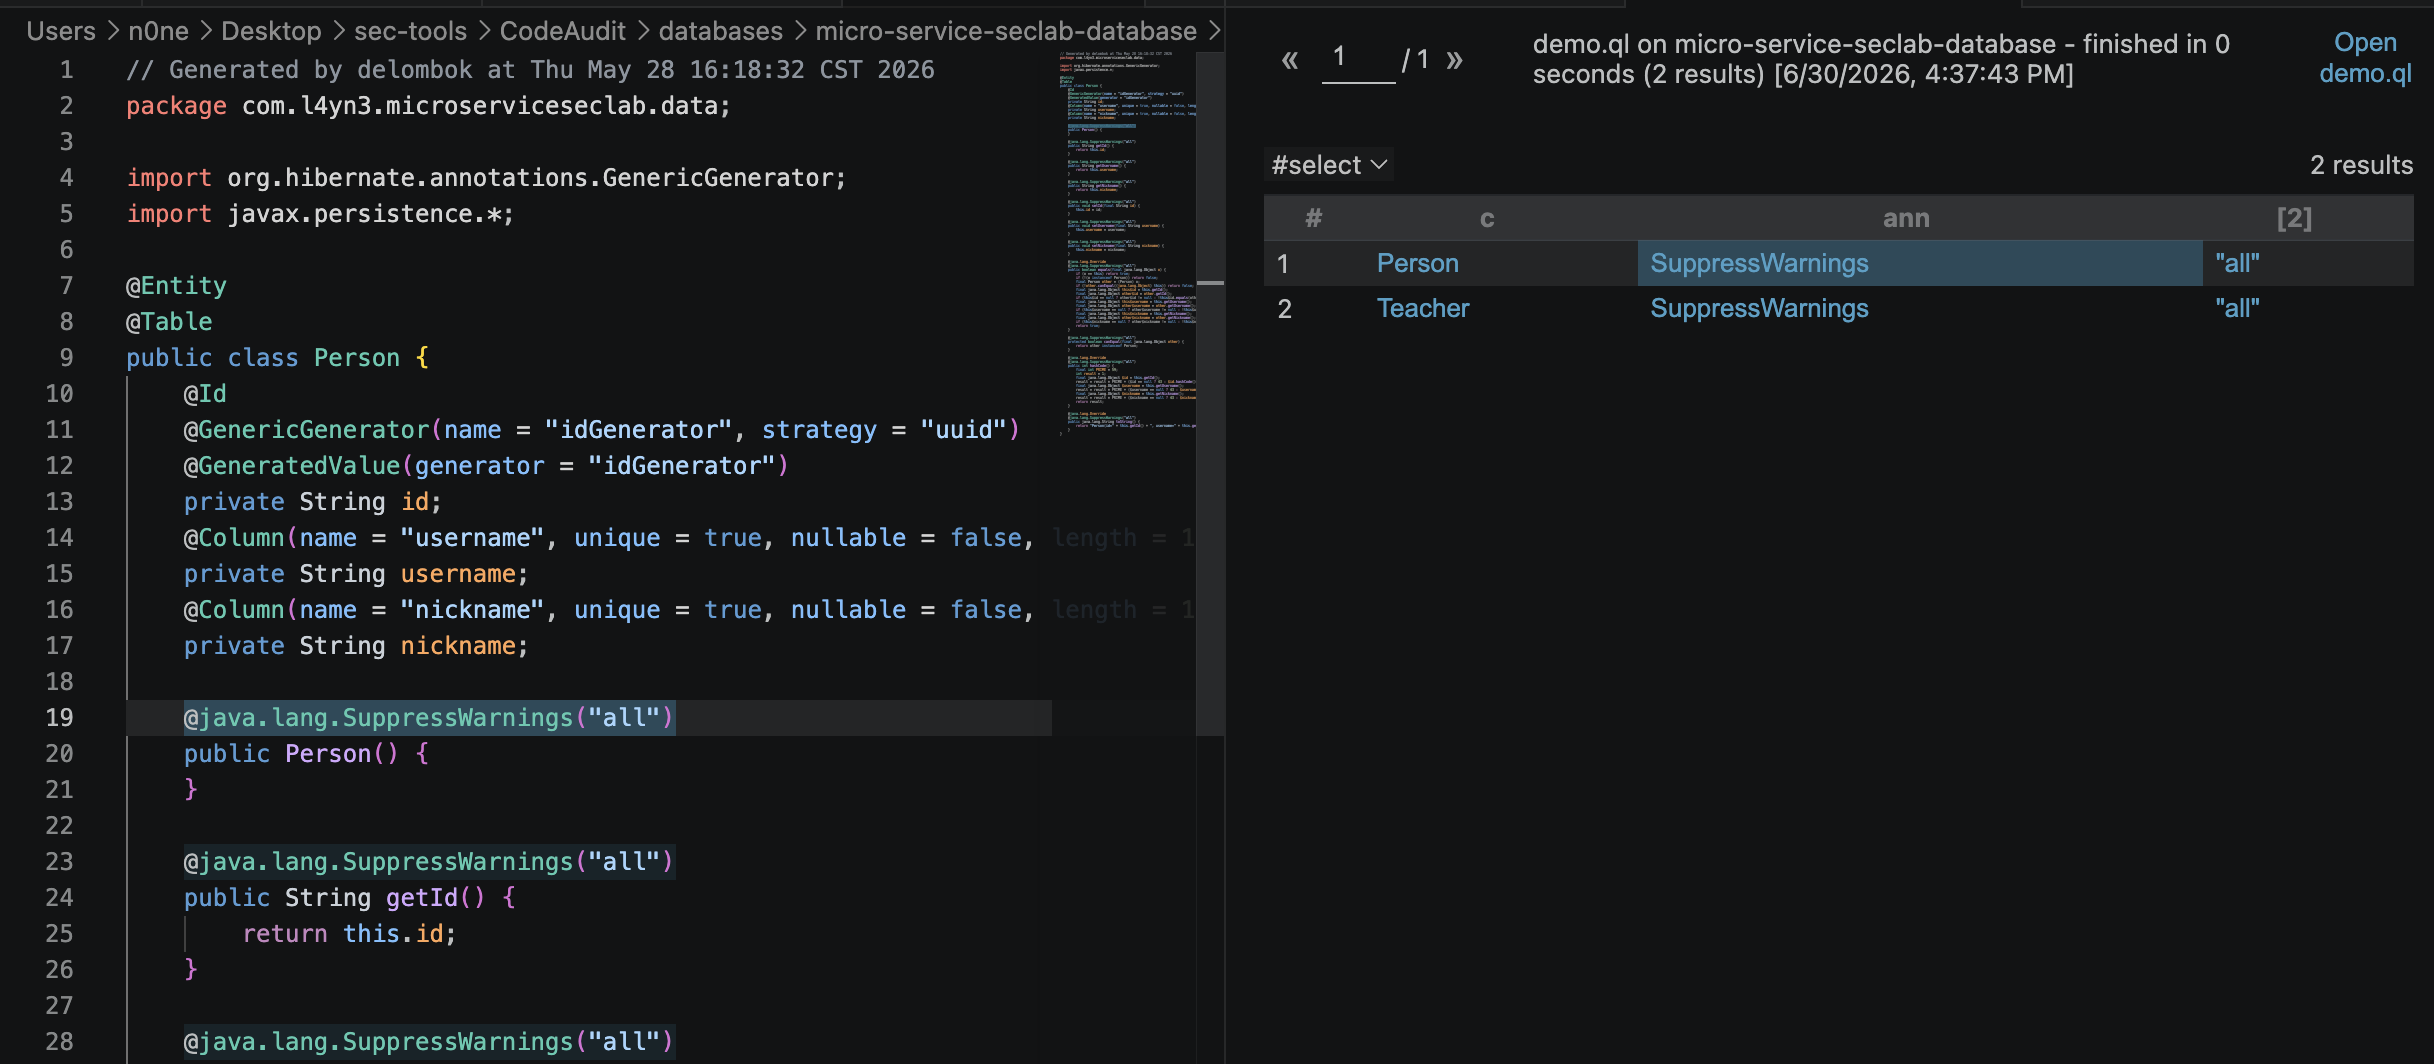
例子:找 **@SuppressWarnings**
1 | import java |
第二个例子:找“应该写 **@Override**却没写”的方法
第一步:定义“什么是 **@Override**注解”
1 | class OverrideAnnotation extends Annotation { |
造了一个新类叫 OverrideAnnotation,它只包含那些种类是 java.lang.Override的注解。
第二步:写查询
1 | from Method overriding, Method base |
overriding.overrides(base):方法overriding重写了方法base。not exists(...):不存在一个OverrideAnnotation类型的注解贴在overriding身上。- 结果:所有重写了父类方法、但自己没写
@Override的方法。
第三个例子:找“调用废弃方法”的地方(并排除合理情况)
- 定义“废弃方法”:贴了
@Deprecated注解的方法。 - 找所有调用这些废弃方法的地方。
- 排除那些调用方自己也是废弃的。
- 再排除那些调用方写了
**@SuppressWarnings("deprecation")**的。
1 | class DeprecatedAnnotation extends Annotation { |
然后找调用:instanceof
1 | from MethodCall call, DeprecatedMethod dm |
call.getMethod() = dm:这个调用调的是废弃方法。call.getEnclosingCallable():调用所在的上级方法(谁调了它)。not ... instanceof DeprecatedMethod:这个上级方法本身不是废弃的。
再升级:排除 @SuppressWarnings("deprecation")
1 | class SuppressDeprecationWarning extends Annotation { |
然后在查询里加:
1 | and not exists(SuppressDeprecationWarning sw | sw = call.getEnclosingCallable().(Annotatable).getAnAnnotation()) |
3.4.Java 数据流与污点追踪
就是数据流是追踪“值”在代码里怎么走的,污点追踪是追踪“脏东西”怎么传染的。
为什么需要数据流分析?
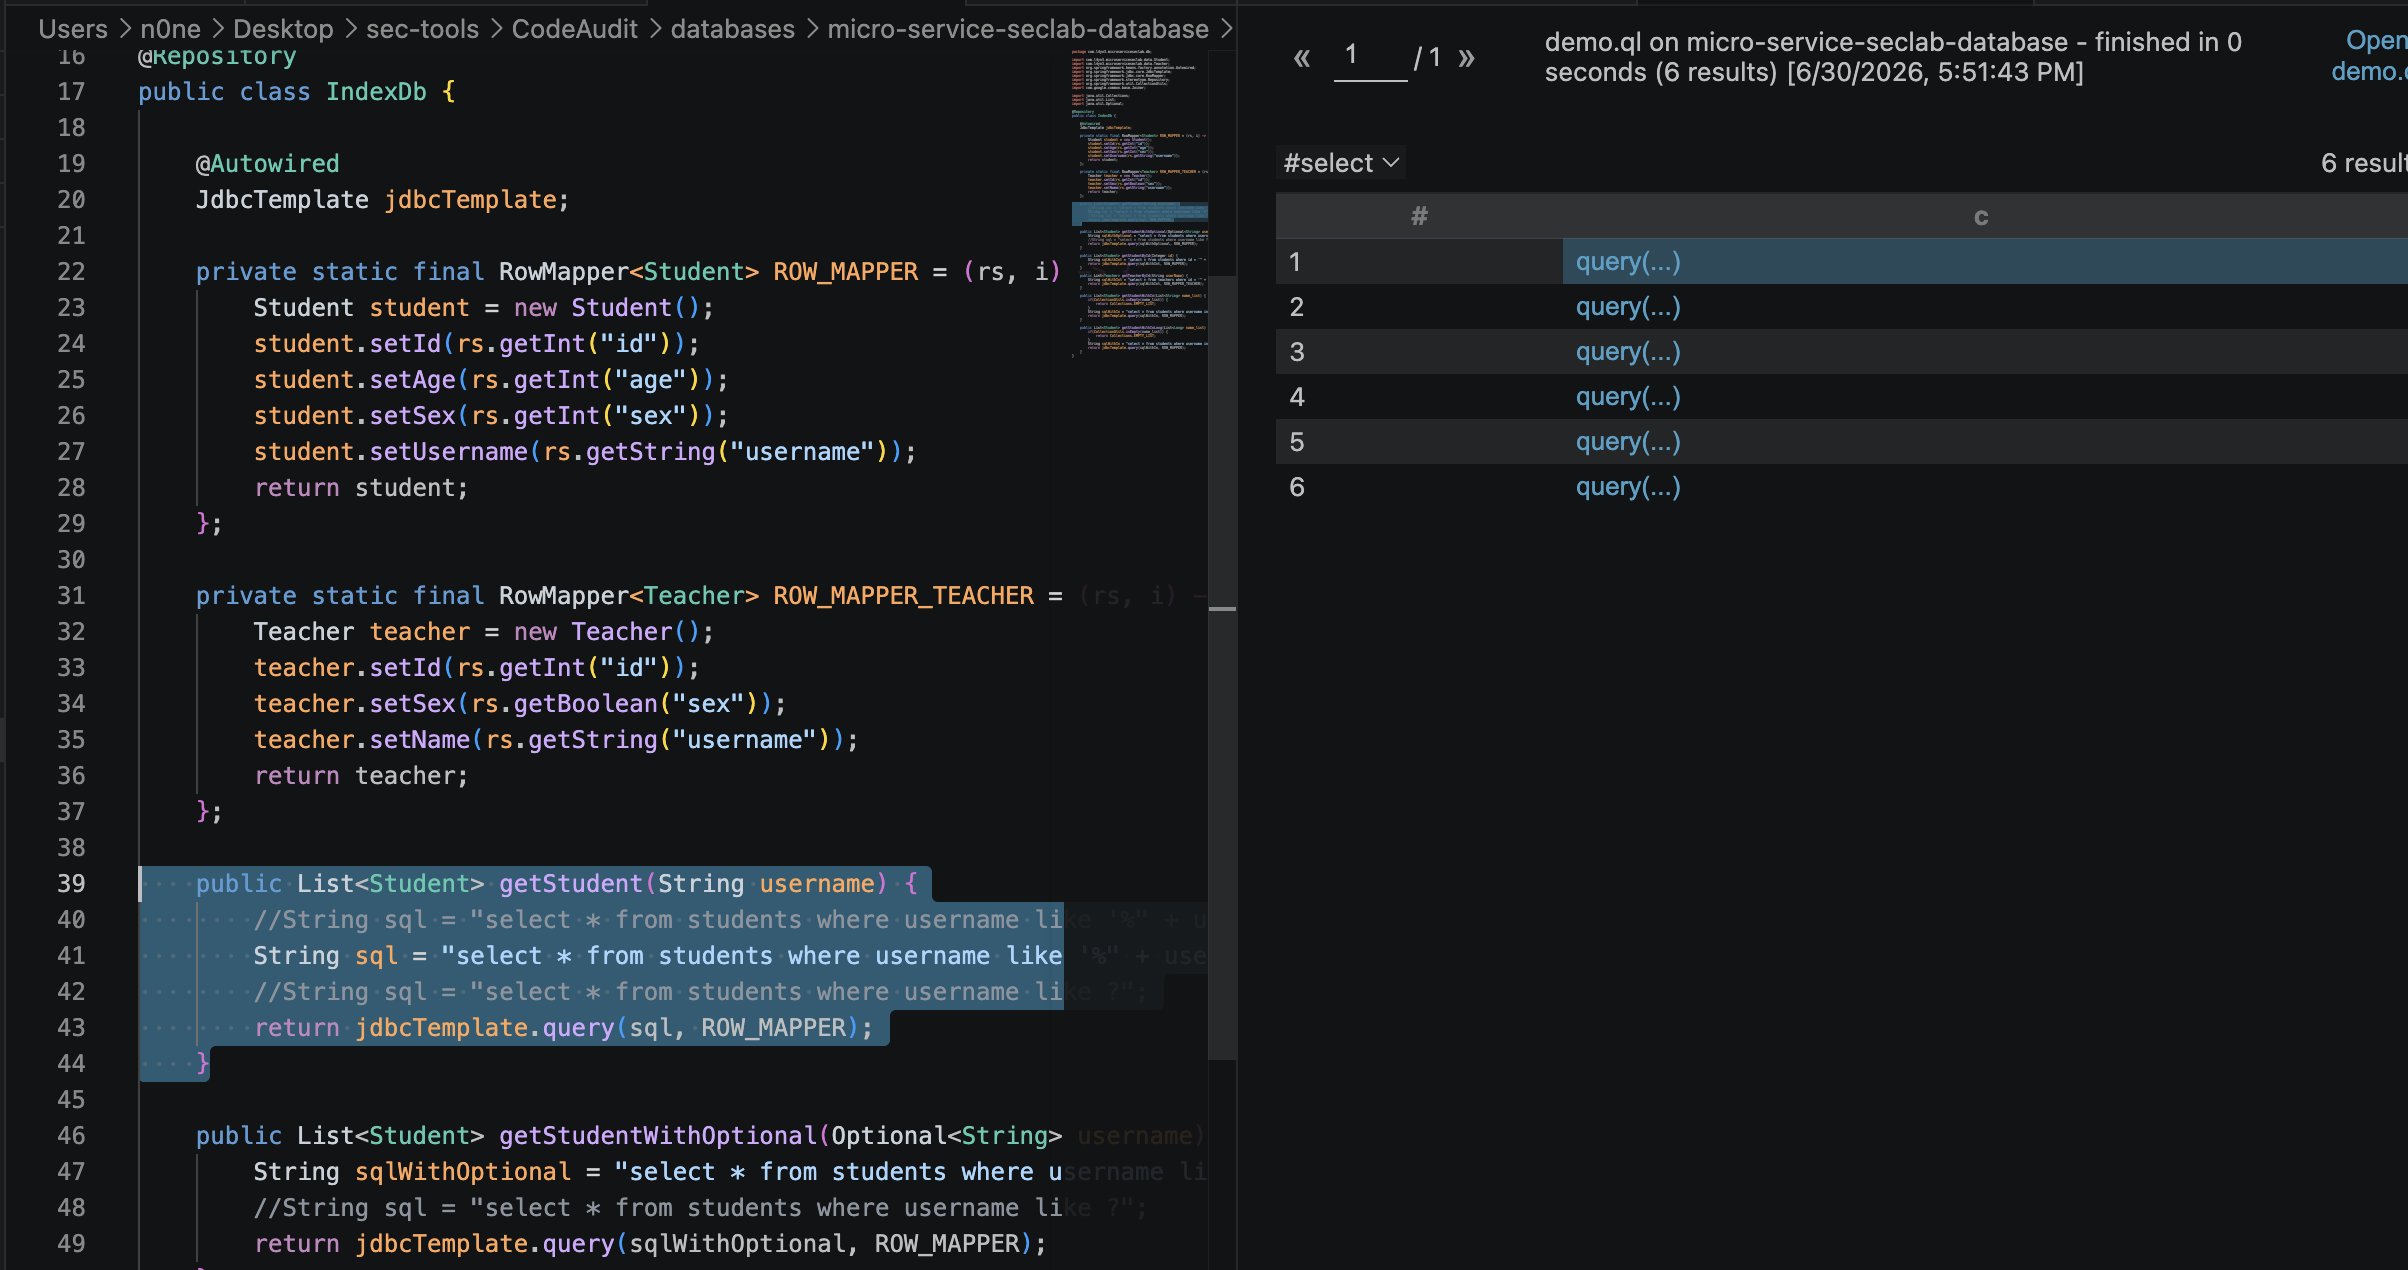
查询query方法被调用,比如:
1 | import java |
这只能找到调用 query 的地方,但看不到参数是从哪来的。比如:
1 | public List<Student> getStudent(String username) { |
光靠“找形状”抓不到 username是用户输入。数据流分析就是顺着代码的赋值、传参、返回值,追踪一个值从出生到使用的地方。
局部数据流:在一个方法里追
核心概念:Node(节点)
数据流分析把代码里的每个“值”出现的地方看作一个节点(Node)。节点有两种:
- 表达式节点(
ExprNode):比如userId、"hello"、a + b - 参数节点(
ParameterNode):比如方法参数String userId
你可以用 DataFlow::exprNode(expr)把一个表达式转成节点,用 DataFlow::parameterNode(param)把参数转成节点。
localFlow:同方法内追
DataFlow::localFlow(src, sink)问:在同一个方法里,值能从 **src**流到 **sink****吗?**
1 | void foo(String userInput) { |
src=userInput(参数节点)sink=sql(表达式节点,即executeQuery的第一个实参)localFlow会告诉你:能,因为userInput被拼接到sql里,然后传给executeQuery。
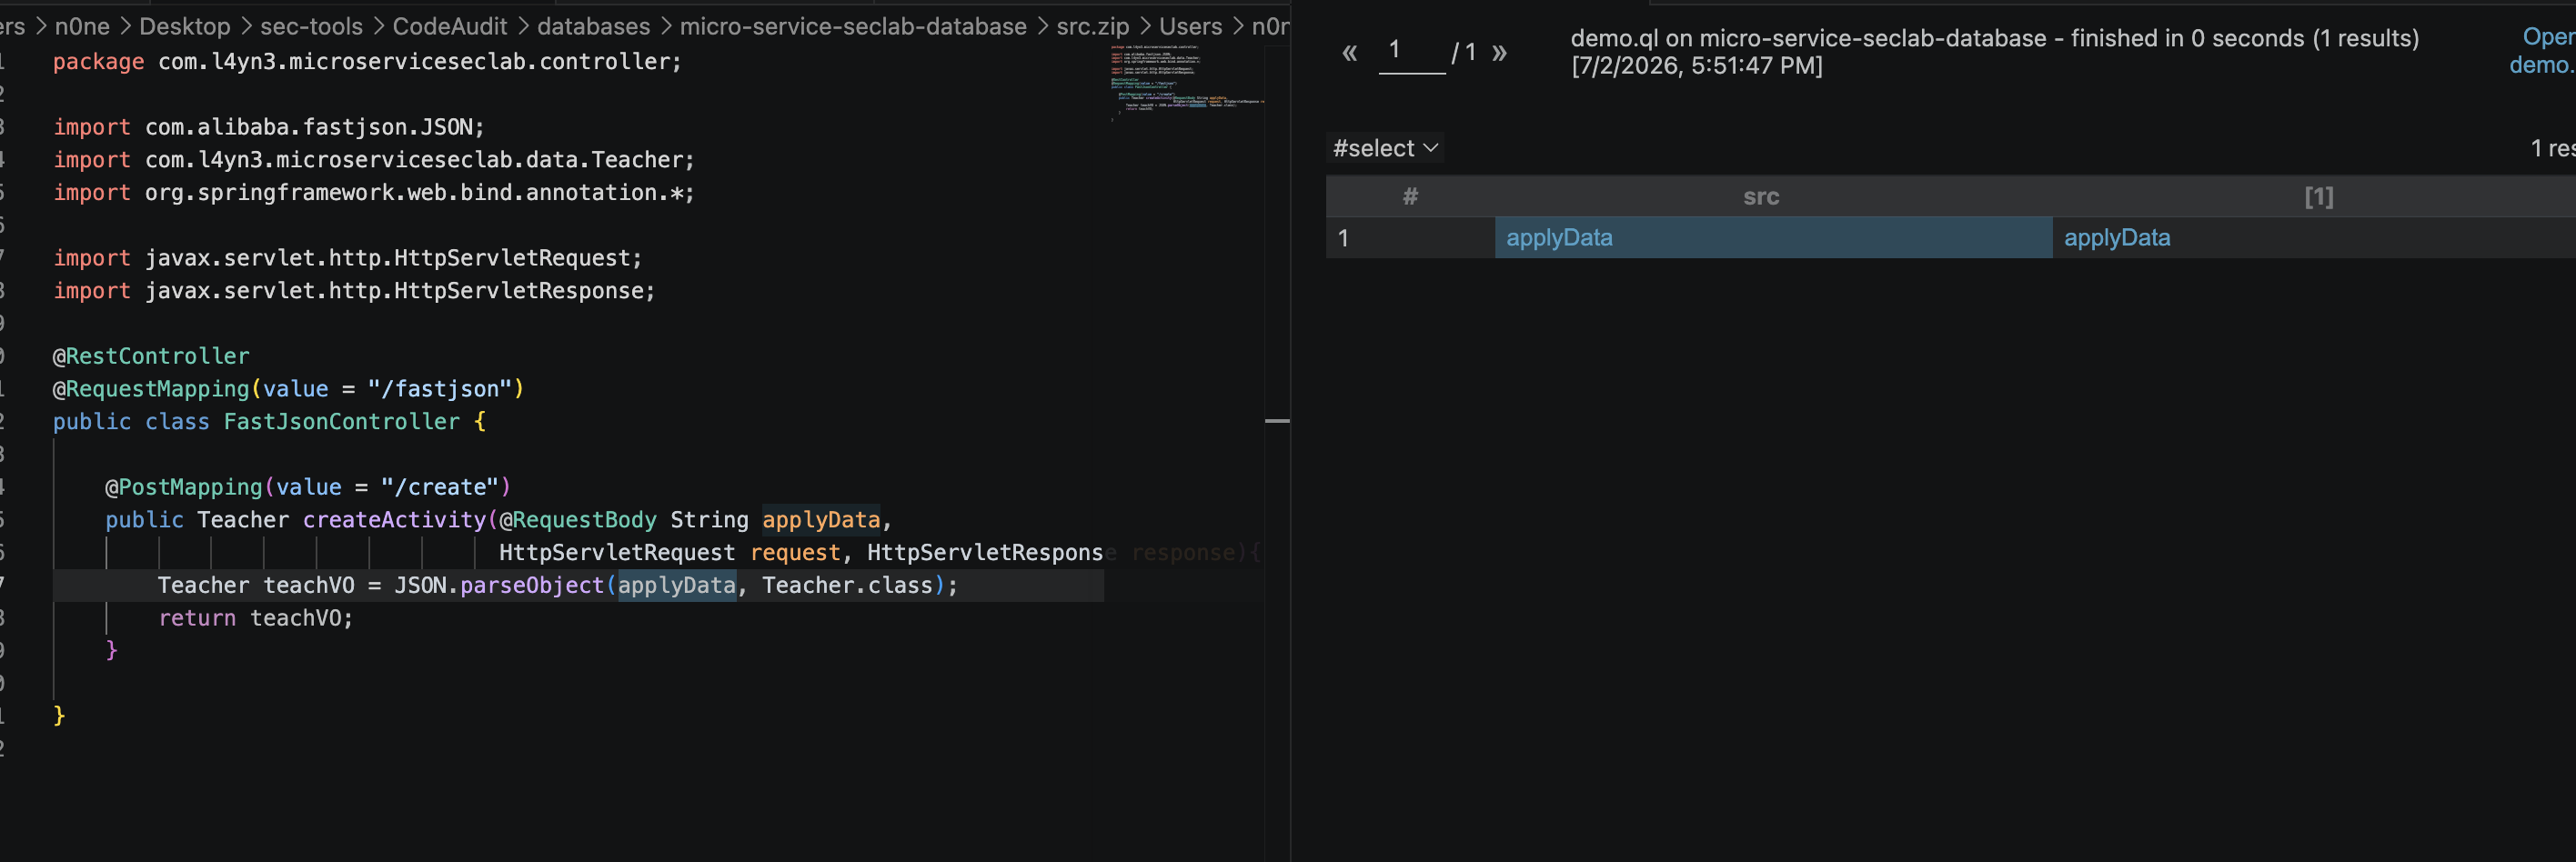
一个简单例子:找 **JSON.parseObject**的参数来源
1 | import java |
Call是所有调用点的基类,包括方法调用和构造器调用。
call.getCallee()返回被调用的目标(可能是 Method或 Constructor),我们通过 .(Method)将其转型为 Method,然后调用 hasQualifiedName来匹配全限定方法名。
hasQualifiedName(“com.alibaba.fastjson”, “JSON”, “parseObject”)的三个参数分别是:包名、类名、方法名。
其余部分不变:追踪第一个参数的数据流来源。
局部污点追踪:不仅追值,还追“脏”
数据流 vs 污点追踪
| 概念 | 追踪什么 | 例子 |
|---|---|---|
| 数据流(data flow) | 值本身 | x = 1; y = x;→ y 的值就是 1 |
| 污点追踪(taint tracking) | “脏不脏” | x = userInput; y = "prefix" + x;→ y 的值不是 userInput,但它“沾了脏” |
关键区别:数据流只认“值相等”,污点追踪认为“只要经过拼接、替换、子串等操作,脏属性会传播”。
localTaint:同方法内追脏
DataFlow::localTaint(src, sink)问:在同一个方法里,脏东西能从 **src**传播到 **sink**吗?
比如:
1 | String x = userInput; // x 脏 |
localTaint会认为 x → y → z都是脏的,即使值本身变了。
好的,我来把官方这篇关于数据流和污点追踪的文档,用你能听懂的大白话重新讲一遍。核心就一句话:数据流是追踪“值”在代码里怎么走的,污点追踪是追踪“脏东西”怎么传染的。
全局数据流:跨方法追
局部追踪只能在一个方法里玩,但在真实的 Spring Boot 项目中,漏洞往往是跨方法的:
1 | // Controller |
这里 input 从 Controller 一路跑到 Service,还经历了字符串拼接。局部流追不到,因为跨越了方法边界。我们要用 **TaintTracking::Global**(全局污点追踪)来搞定它。
全局数据流配置
你需要定义一个“配置”,告诉引擎:
- source(源头):数据从哪来(比如方法参数、用户输入)
- sink(终点):数据流到哪算危险(比如
executeQuery的参数
一句话核心总结:
在 CodeQL 里,数据流(DataFlow)是追踪“一模一样的值”在代码里怎么跑的;污点追踪(TaintTracking)是追踪“脏东西(被污染的属性)”是怎么传染的。
全局污点追踪写法(模块化 API):
你需要定义一个“配置模板”,告诉引擎“源头在哪”和“终点在哪”:
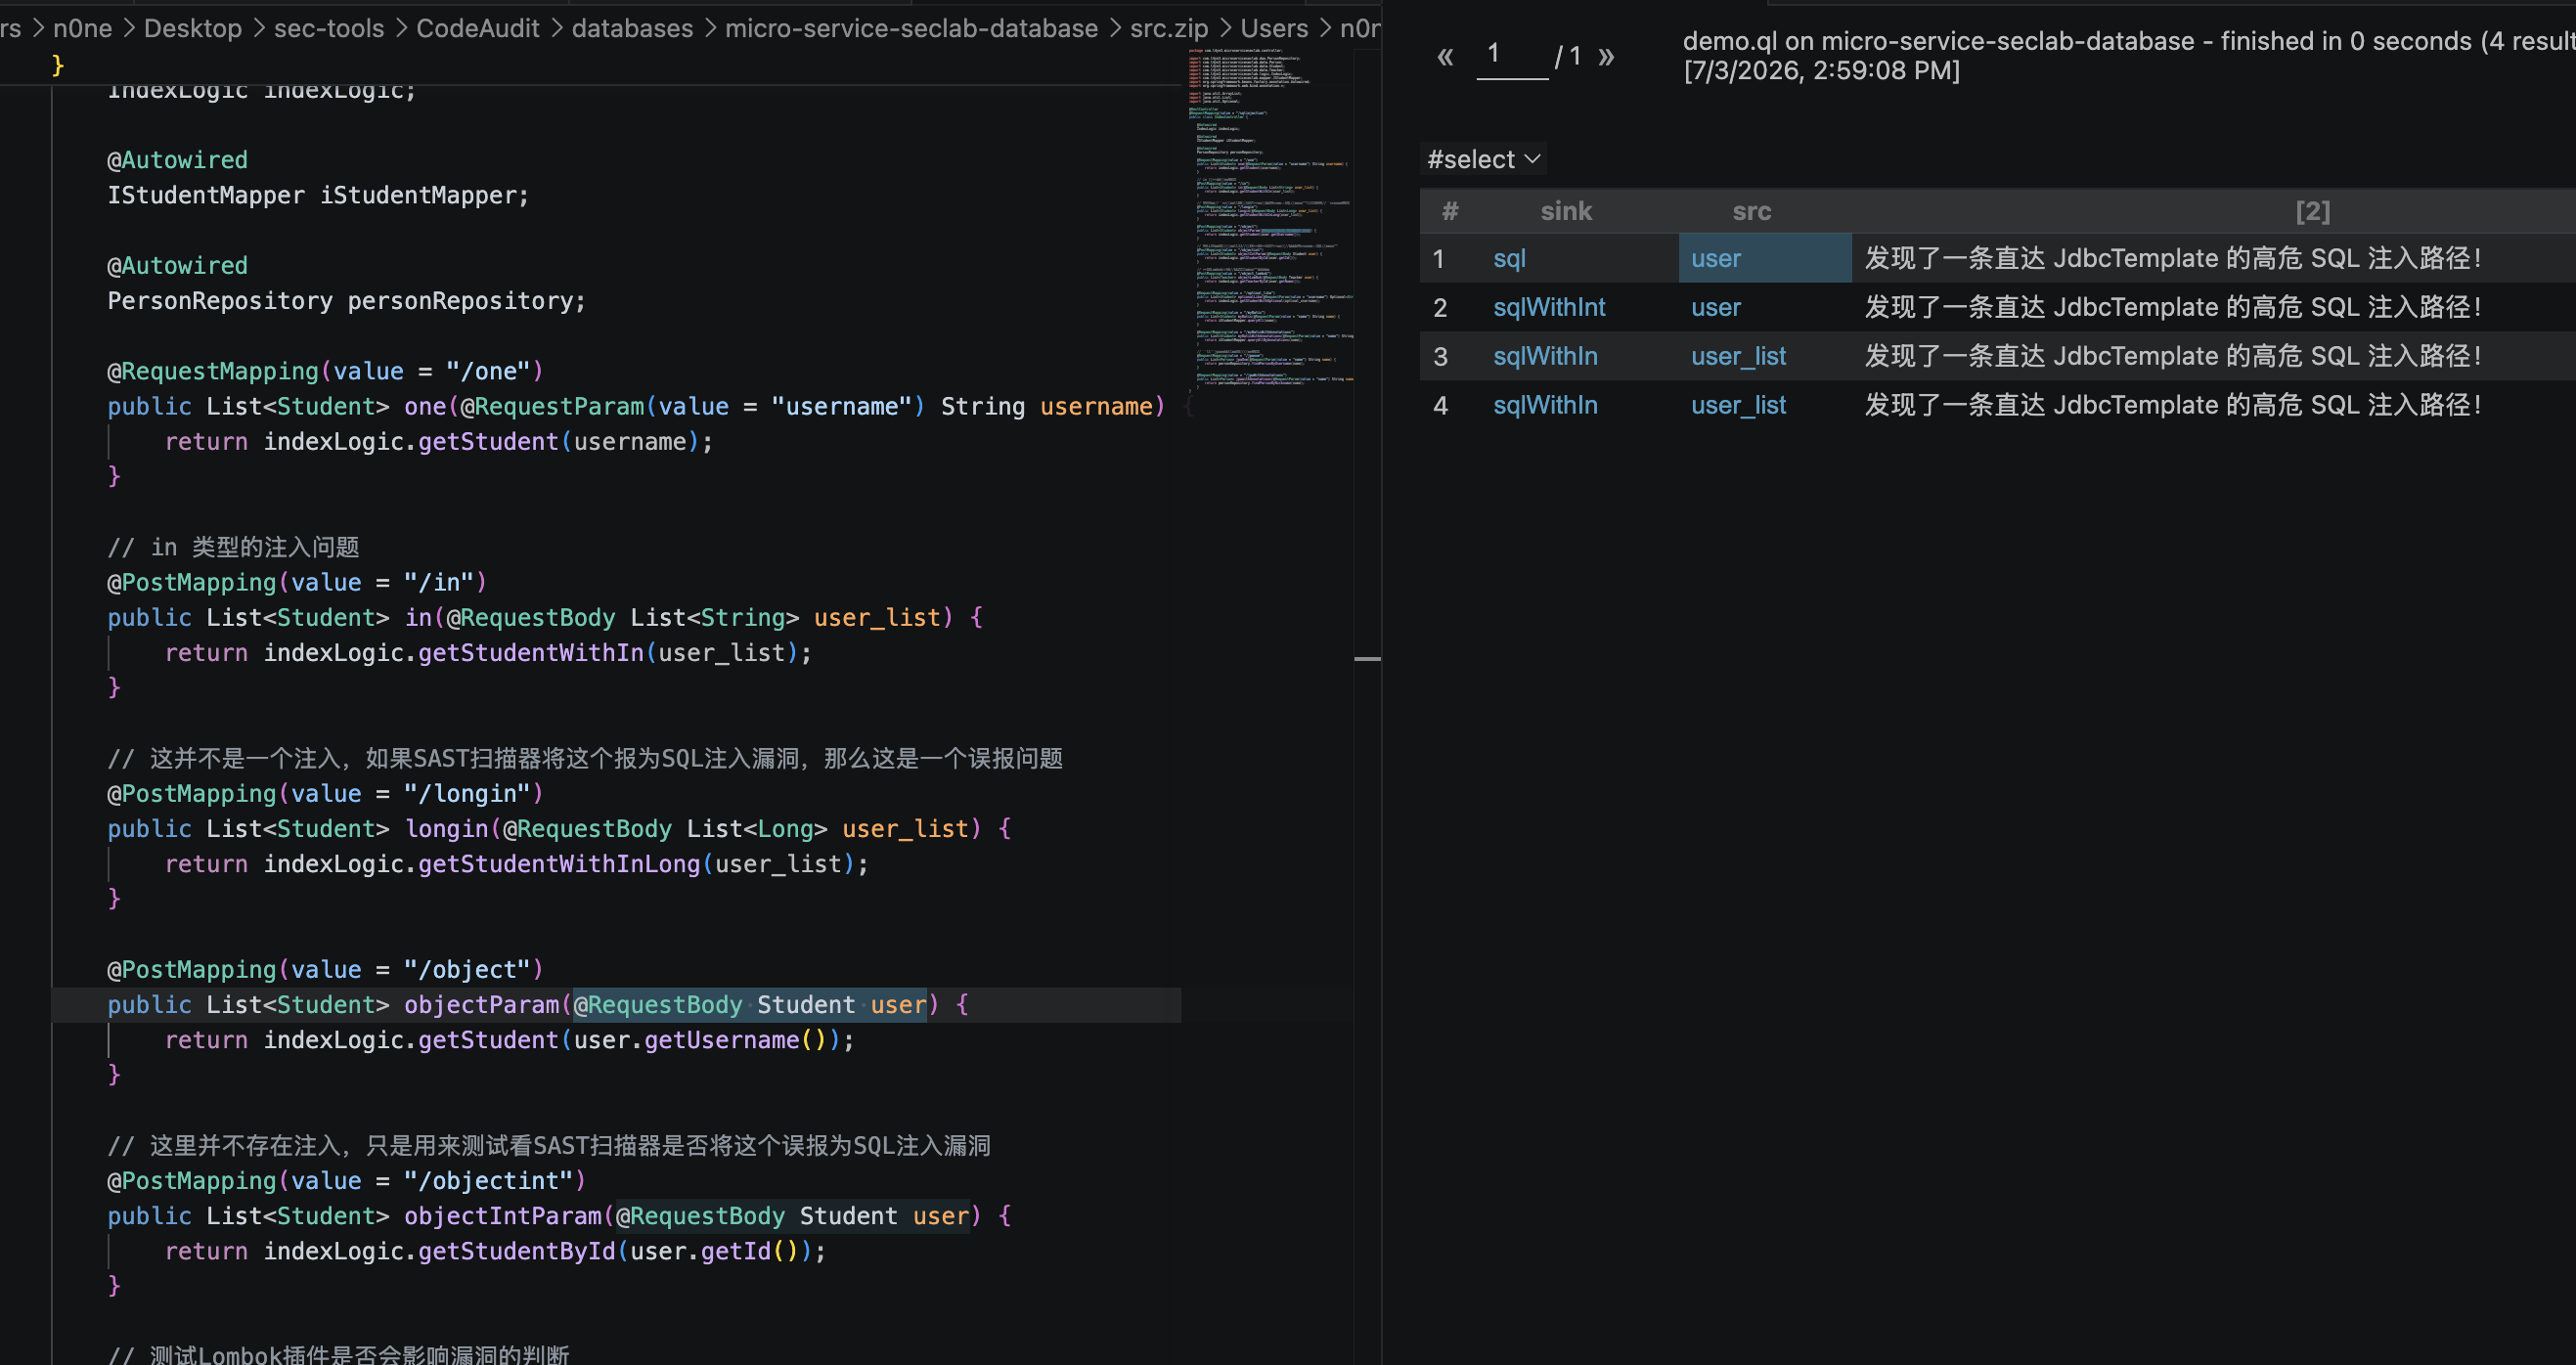
1 | import java |
大白话总结: 挖真实漏洞时,99% 的情况下你都会用 **TaintTracking**(污点追踪)而不是普通的 **DataFlow**。你只需要套用上面的模板,修改里面的 isSource 和 isSink,引擎就会自动帮你穿透一层层的方法调用,把隐藏极深的漏洞揪出来!
1 | import java |
3.5.Java 安全审计实战规则库总目录
GitHub 官方维护的 Java 安全审计规则库——里面全是 .ql查询文件,按 CWE 编号分类,每个文件就是一条“检测某种漏洞模式”的现成规则。
https://github.com/github/codeql/tree/main/java/ql/src/Security
目录结构拆解
codeql/java/ql/src/Security/
├── CWE/ ← 核心,按 CWE 编号分目录
│ ├── CWE-020/ ← 外部输入不当(Log4j 那种算这)
│ ├── CWE-022/ ← 路径穿越(../ 那种)
│ ├── CWE-078/ ← OS 命令注入(Runtime.exec)
│ ├── CWE-079/ ← XSS
│ ├── CWE-089/ ← SQL 注入(JPA/MyBatis/Hibernate)
│ ├── CWE-117/ ← 日志注入(Log4j 也沾边)
│ ├── CWE-209/ ← 错误信息泄露
│ ├── CWE-276/ ← 文件权限不当
│ ├── CWE-295/ │ 证书校验
│ ├── CWE-319/ │ 明文传输
│ ├── CWE-328/ │ 弱加密
│ ├── CWE-330/ │ 弱随机数
│ ├── CWE-338/ │ SecureRandom
│ ├── CWE-477/ │ 使用过时函数
│ ├── CWE-502/ ← ★ 反序列化(CC/Commons-Beanutils/Fastjson 都在这)
│ ├── CWE-611/ ← XXE
│ ├── CWE-614/ │ 不安全的 Cookie
│ ├── CWE-643/ ← XPath 注入
│ ├── CWE-798/ │ 硬编码凭证
│ ├── CWE-829/ │ 组件依赖漏洞(SCA 向)
│ └── …更多
├── qlpack.yml ← 这个包的元数据(依赖、名称)
├── definitions.ql ← 一些共享定义
└── codeql-suites/ ← 可以一次性跑的 suite 文件
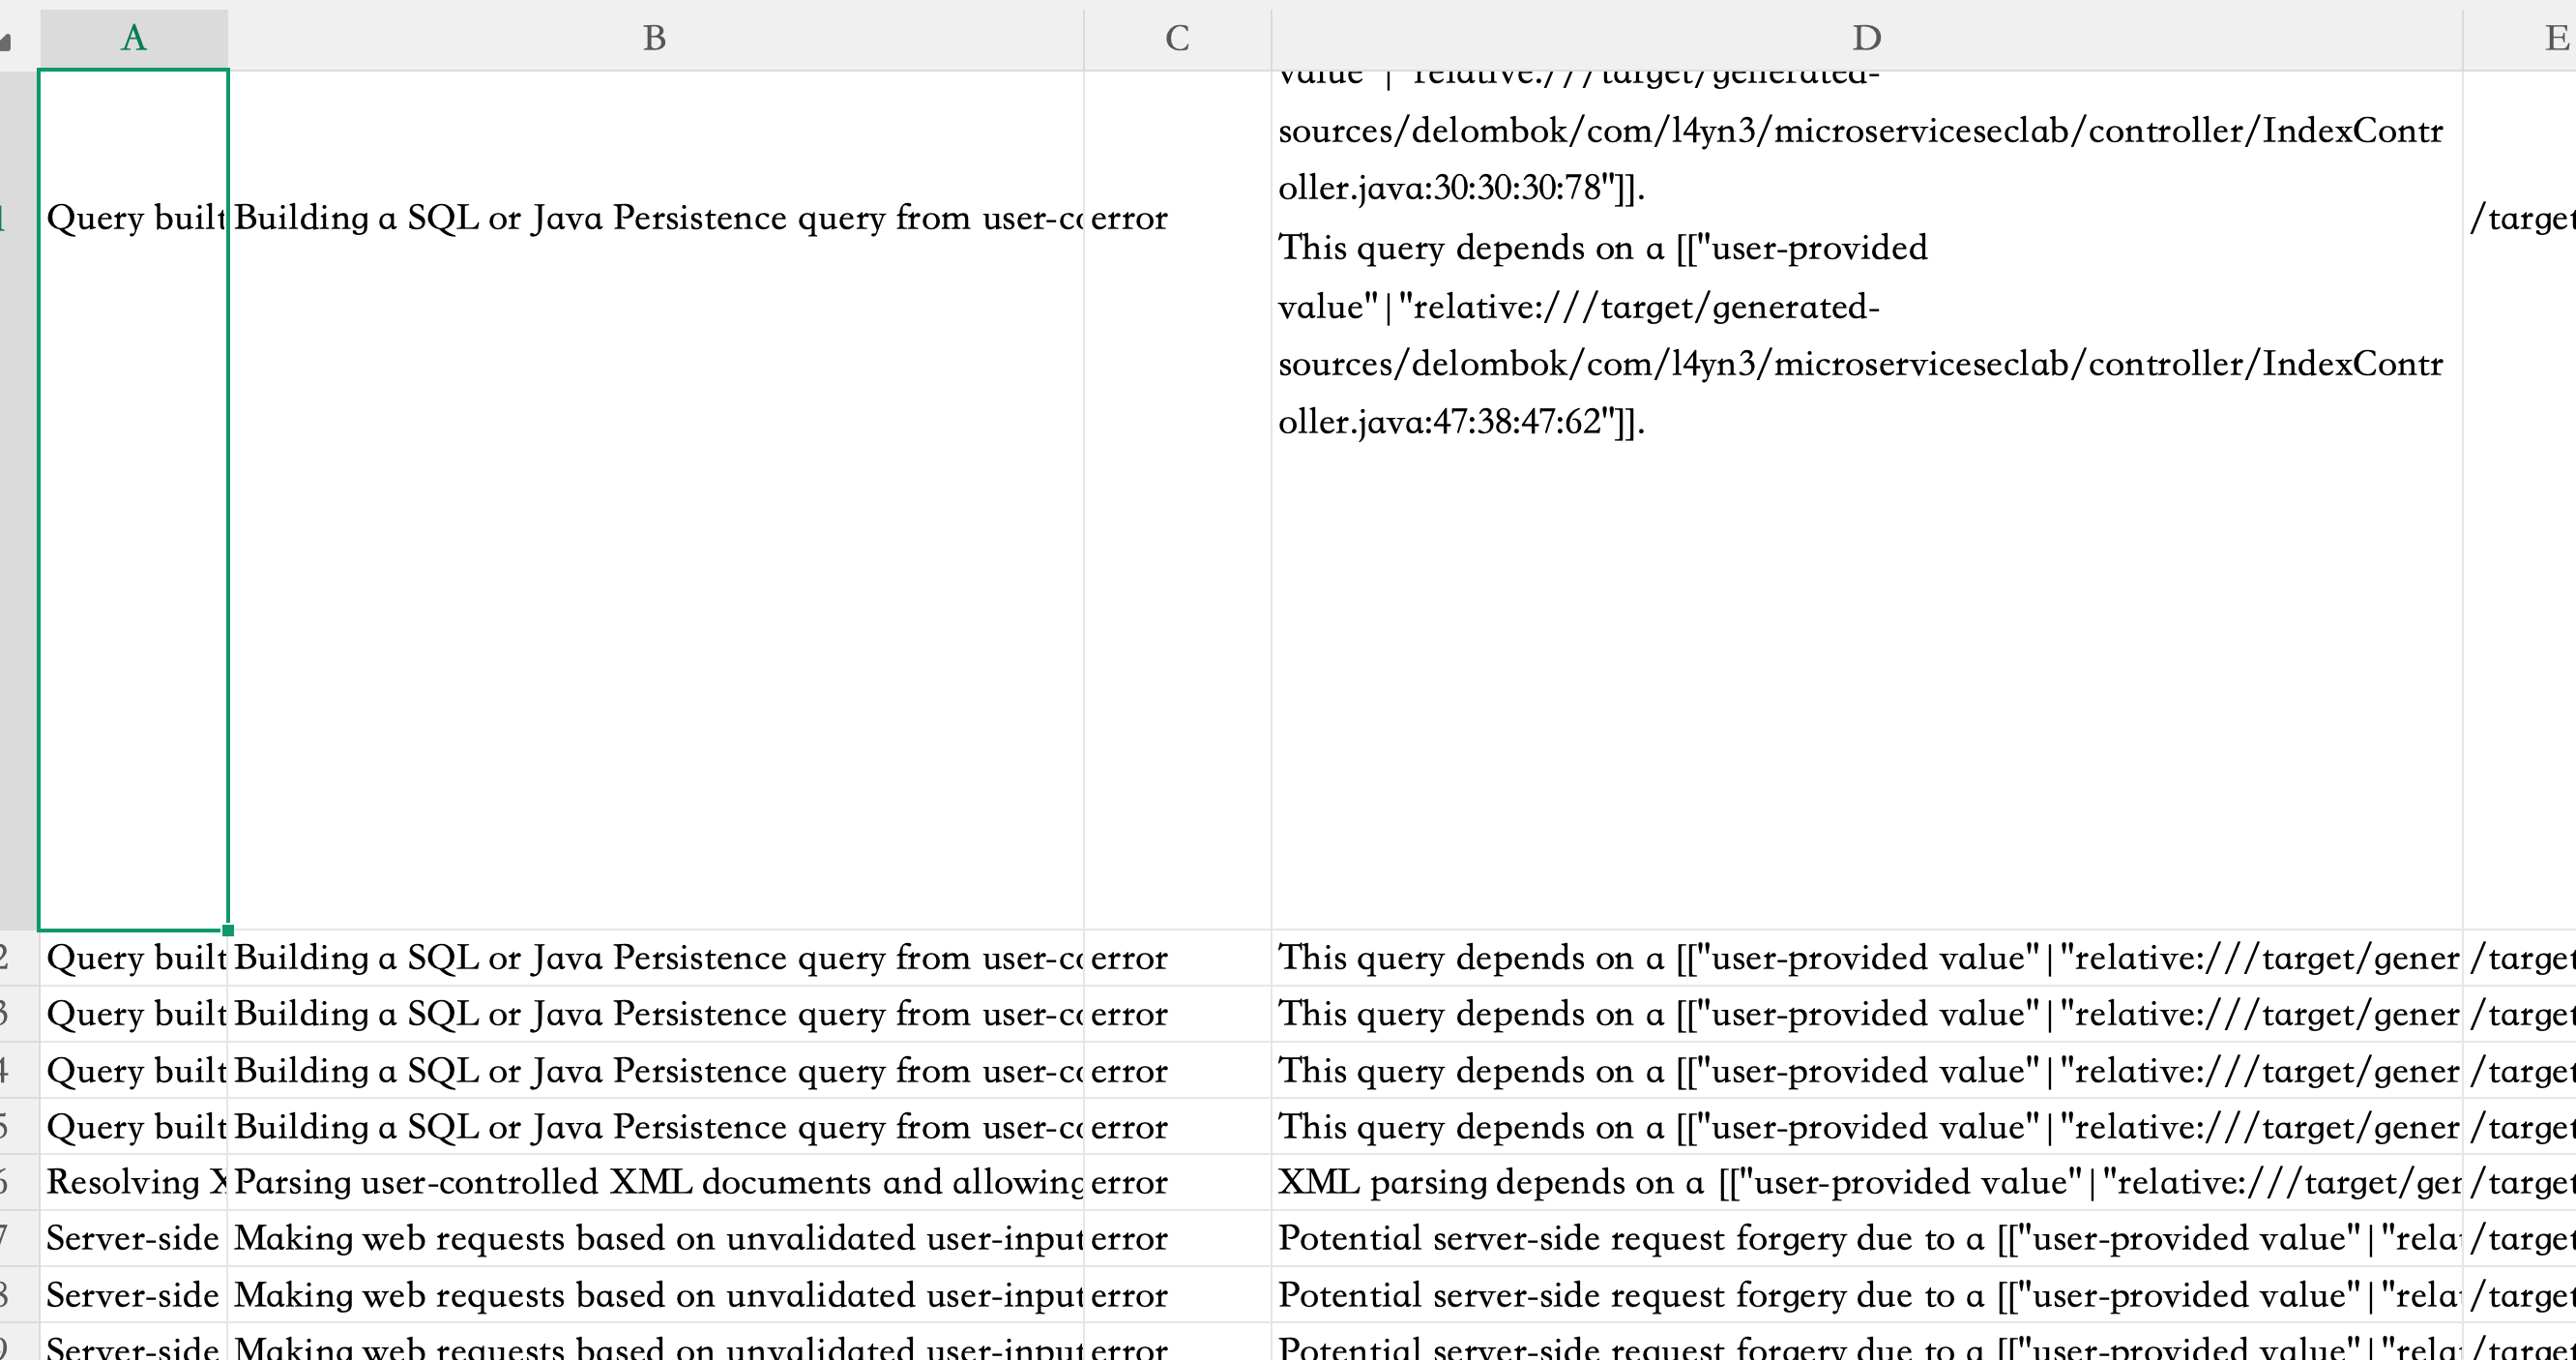
使用规则库扫描
1 | codeql database analyze <你的数据库路径> \ |
跑完 results.csv里就是所有命中的漏洞点位(文件、行号、CWE 编号、置信度)
如果想跑部分的
使用部分规则库扫描
1 | codeql database analyze <数据库路径> \ |
VS Code 里更简单:在 CWE-502目录里随便点一个 .ql右键 → “CodeQL: Run Query”,只跑那一条。
自己写个 mini suite(推荐,最实用)
suite 文件就是个 YAML,用来打包你想跑的查询。在随便一个目录(比如你项目根)新建 my-audit.qls:
1 | # ============================================================ |
然后跑:
1 | codeql database analyze <数据库路径> \ |